Étude des tableaux associatifs
Préliminaires
L’épreuve est composée d’un problème unique, comportant 34 questions. Le problème consiste en l’étude et l’implémentation d’un tableau associatif en C, suivant différentes méthodes.
Le problème est divisé en 4 sections distinctes : — l’implémentation du tableau associatif en utilisant une structure d’arbre (section 1), — l’ajout d’un « ramasse miettes » pour gérer la mémoire (section 2), — l’implémentation du tableau associatif en utilisant un algorithme probabiliste (section 3), — la conception d’un analyseur syntaxique pour créer un tableau associatif à partir d’une chaîne de caractères (section 4).
Les quatre sections sont indépendantes.
Travail attendu
Les résultats attendus pour certaines questions pourront être admis afin de faciliter la résolution des questions suivantes. Le langage C constitue l’unique langage autorisé pour le traitement des questions de programmation.
Une attention particulière sera portée quant à la correction et la lisibilité du code proposé.
Si une tolérance raisonnable peut être envisagée sur certains aspects syntaxiques dans le cadre d’une épreuve réalisée sur support papier (par exemple, l’oubli d’un « ; »), un code difficilement lisible ou l’emploi de fonctions ou structures de contrôle non conformes aux standards du langage C, notamment celles empruntées à d’autres langages, sera sanctionné.
Un soin particulier sera également apporté à la gestion de la mémoire, à la bonne initialisation des structures ainsi qu’au contrôle systématique des allocations mémoires.
La gestion rigoureuse des erreurs sera valorisée (l’utilisation d’assert est recommandée), de même que la qualité, la simplicité et la lisibilité du code.
En conformité avec le programme officiel, il sera admis que certains en-têtes standards soient présupposés comme inclus dans le code :
Les tableaux associatifs
Les tableaux associatifs
sont des structures de données permettant un accès rapide à une valeur à partir d’une clef. Afin de simplifier l’écriture du code, nous considèrerons que les clefs sont toujours de type char* et les valeurs de type int.
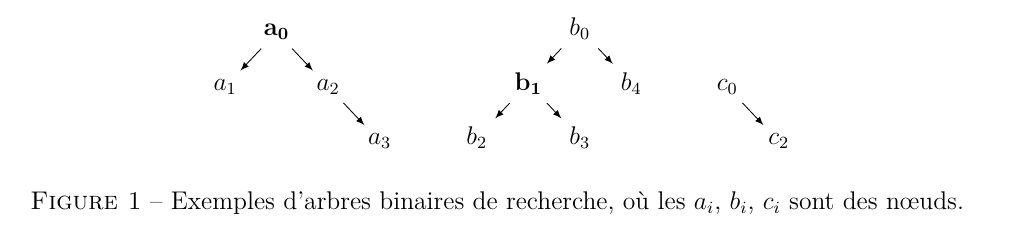
1 – Implémentation par un arbre binaire de recherche Le but de cette section est d’étudier une implémentation d’un tableau associatif reposant sur un arbre binaire de recherche.
Nous adopterons une approche fonctionnelle pour l’implémentation des structures de données, en les considérant comme immuables. Ainsi, chaque fonction de manipulation renverra systématiquement une nouvelle version modifiée de la structure, sans altérer l’originale.
Cette méthode présente l’avantage d’éliminer les effets de bord lors des appels de fonction. Toutefois, elle implique une augmentation du nombre d’allocations mémoire, puisque chaque modification nécessite la création d’une copie de la structure de données.
Dans cette section nous ne nous occuperons pas de la récupération de la mémoire, car nous introduirons en section 2 un « ramasse miettes » pour gérer la mémoire automatiquement.
Arbre binaire de recherche
Définitions : Soit A un arbre binaire de recherche. On notera avec une lettre minuscule (par exemple x ou y) un nœud de A, et avec une lettre majuscule (par exemple {T_1,T_2} ou {T_3}) un sous-arbre de A.
Soit x un nœud, on notera {x_{\mathrm{gauche}}} et {x_{\mathrm{droit}}}, respectivement le sous-arbre gauche et le sous-arbre droit de x. On rappelle que la taille d’un arbre est égale au nombre de nœuds qu’il contient.
Pour un arbre de racine x, on notera h(x) sa hauteur, et on définit récursivement la hauteur d’un arbre par : — la hauteur d’un arbre vide est {-1}, — {h(x)=\max(h(x_{\mathrm{gauche}}),h(x_{\mathrm{droit}}))+1}.
Pour un arbre de racine x, on définit la valeur d’équilibre par : {e(x)=h(x_{\mathrm{gauche}})-h(x_{\mathrm{droit}})} On qualifiera d’équilibré un arbre binaire de recherche A si pour tout nœud x de A, {-1\le e(x)\le1} Définition : On définit un nœud d’un arbre binaire de recherche par la structure suivante :
|
1 2 3 4 5 6 7 8 |
struct abrNoeud_s { char* clef; int valeur; struct abrNoeud_s* fils_gauche; struct abrNoeud_s* fils_droit; }; typedef struct abrNoeud_s abrNoeud; |
On utilisera la valeur du champ clef pour ordonner les nœuds de l’arbre, en utilisant l’ordre alphabétique.
La signature de la fonction est :
|
1 |
char* copie_chaine(char* chaine) |
Indication C : On considèrera que la chaîne de caractères passée en paramètre (chaine) n’est jamais NULL.
La signature de la fonction est :
|
1 2 3 |
abrNoeud* abr_creer_noeud(char* clef, int valeur, abrNoeud* fils_gauche, abrNoeud* fils_droit) |
Indication C : le champ clef du nœud créé doit contenir une copie de la chaîne de caractères passée en paramètre.
Par contre, il n’est pas nécessaire de dupliquer les sous-arbres passés en paramètre.
La signature de la fonction est :
|
1 |
int abr_equilibre(abrNoeud* noeud) |
Sans proposer de code, expliquer quelles seraient les modifications à apporter à la structure de donnée et/ou à l’algorithme pour améliorer cette complexité ?
La signature de la fonction est :
|
1 |
int abr_rechercher(abrNoeud* noeud, char* clef) |
Indication : On considèrera que la clef donnée est toujours dans l’arbre binaire de recherche.
Indication C : l’opérateur == permet de comparer des entiers ou des pointeurs mais pas de comparer le contenu de deux chaînes de caractères.
2. Ajout d’un ramasse miettes
Un « ramasse miettes » est un ensemble de fonctions qui permet de gérer la mémoire de manière automatique. L’idée est de libérer la mémoire qui avait été allouée dynamiquement pour des structures ou des tableaux lorsque ces derniers ne sont plus utilisés.
Dans un contexte fonctionnel où les données sont immuables, il est parfois compliqué de déterminer le moment opportun pour libérer la mémoire allouée aux nœuds.
En effet, l’immuabilité des structures permet de partager le même sous-arbre à plusieurs endroits d’un arbre, sans indication explicite de ce partage, rendant ainsi difficile de savoir si un nœud doit être libéré ou non. L’utilisation d’un ramasse miettes dans un tel cas est donc tout indiquée.
C’est ce que nous allons étudier dans cette section. Pour simplifier le problème, nous considérons qu’une structure ou un tableau devient inutilisé dès lors qu’il n’est plus atteignable à partir des variables globales du programme.
Autrement dit, en partant des variables globales, il est impossible d’y accéder en suivant des pointeurs, même de manière transitive. Pour pouvoir décrire l’algorithme de ramasse miettes qui nous intéresse, nous avons besoin de considérer qu’un nœud peut être « marqué ».
Cela consiste à mémoriser une information dans la structure elle-même. Dans notre situation, nous utiliserons la structure suivante :
|
1 2 3 4 5 6 7 8 9 10 11 |
struct abrNoeud_s { char* clef; int valeur; struct abrNoeud_s* fils_gauche; struct abrNoeud_s* fils_droit; // partie propre au ramasse-miettes bool marque; }; typedef struct abrNoeud_s abrNoeud; |
Un nœud est alors dit « marqué » si et seulement si le champ marque a pour valeur true. Nous considérons qu’initialement aucun nœud n’est marqué.
L’algorithme de ramasse miettes fonctionne en deux temps :
1. Marquer tous les nœuds atteignables par clôture transitive depuis les variables globales.
C’est-à-dire tous les nœuds atteignables directement ou bien atteignables à partir d’un nœud lui-même atteignable.
2. Libérer tous les nœuds alloués mais non marqués et effacer la marque des nœuds
marqués.
En déduire (sans démonstration) la complexité en temps de l’algorithme de marquage et de l’algorithme de libération.
Pour pouvoir libérer tous les nœuds non marqués il est nécessaire de maintenir une liste des nœuds de l’arbre alloués en mémoire. Nous proposons d’utiliser la structure de données suivante :
|
1 2 3 4 5 |
struct rmListeMemoire_s { abrNoeud* element; struct rmListeMemoire_s* suivant; }; typedef struct rmListeMemoire_s rmListeMemoire; |
La signature de la fonction est :
|
1 2 |
rmListeMemoire* rm_inserer_tete(abrNoeud* element, rmListeMemoire* liste) |
Indication : la donnée référencée par liste n’a pas besoin d’être modifiée.
Nous considérons maintenant la structure de donnée RM permettant de mémoriser dans le champ arbres les nœuds racines des différents arbres binaires de recherche accessibles (dans notre cas il peut y avoir jusqu’à 16 nœuds racines) ainsi que la liste des nœuds alloués :
|
1 2 3 4 5 6 7 8 9 |
#define MAX_NB_ARBRES 16 struct RM_s { abrNoeud* arbres[MAX_NB_ARBRES]; /* arbres accessibles */ int nb_elements; /* nombre total de noeuds alloués */ rmListeMemoire* premierElement; }; typedef struct RM_s RM; RM* rm; /* variable globale pour l’ensemble du programme */ |
Le champ premierElement est une référence vers le premier élément d’une liste.
Cette dernière est gérée de la façon suivante : — lorsqu’un nœud d’un arbre binaire de recherche est alloué, il est ajouté à la liste,
— lorsqu’un nœud d’un arbre binaire de recherche est libéré, il est retiré de la liste.
|
1 |
RM* rm_creer_rm(void) |
Le code suivant correspond aux deux étapes de l’algorithme de ramasse miettes :
|
1 2 3 4 5 6 7 8 9 10 11 12 |
void rm_ramasse_miettes(RM* rm) { assert(rm != NULL); int nb_noeuds = rm->nb_elements; for (int i = 0; i < MAX_NB_ARBRES; i++) { if (rm->arbres[i] != NULL) { rm_marquer_elements_accessibles(rm->arbres[i]); } } rm_recuperer_elements_inaccessibles(rm); printf("noeuds!collectes!:!%d,!", nb_noeuds - rm->nb_elements); printf("noeuds!encoreffaccessibles!:!%d\n", rm->nb_elements); } |
La signature de la fonction est :
|
1 |
void rm_marquer_elements_accessibles(abrNoeud* element) |
Pour libérer tous les nœuds non marqués on considère la fonction suivante :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 |
void rm_recuperer_elements_inaccessibles(RM* rm) { assert(rm != NULL); rmListeMemoire* objet = rm->premierElement; rmListeMemoire* objets_conserves = NULL; while (objet != NULL) { if (!objet->element->marque) { /* Ce noeud n’a pas été marqué, on le retire de la liste et on le libère */ rmListeMemoire* a_detruire = objet; objet = a_detruire->suivant; // PARTIE A // ici il faut libérer la mémoire // FIN PARTIE A rm->nb_elements--; } else { // PARTIE B /* Ce noeud a été marqué, on enlève la marque et on passe au noeud suivant */ objet->element->marque = false; rmListeMemoire* a_garder = objet; objet = a_garder->suivant; // FIN PARTIE B } } rm->premierElement = objets_conserves; } |
L’algorithme est le suivant : — on parcourt tous les éléments de la liste premierElement, — si le nœud n’est pas marqué, il faut libérer la mémoire et enlever le nœud de la liste, — si le nœud est marqué il faut enlever la marque et le laisser dans la liste.
Il n’est pas nécessaire de recopier le code autour.
Il n’est pas nécessaire de recopier le code autour.
3. Implémentation par l’utilisation d’un algorithme
probabiliste Nous allons nous intéresser dans cette section à une autre manière d’implémenter un tableau associatif, en utilisant un algorithme probabiliste : les « skip lists ».
3.1. Principe des skip lists
Une skip list est une liste chaînée optimisée pour accélérer la recherche d’un élément. Pour ce faire, certains nœuds stockent dans un tableau des pointeurs vers d’autres nœuds situés plus loin dans la liste.
Chaque case du tableau correspond à un « niveau » et un pointeur de niveau i mène vers un nœud qui possède lui aussi un pointeur de niveau i. Le niveau 0 contient l’ensemble des éléments, classés par ordre alphabétique en fonction de leur clef.
Les niveaux supérieurs regroupent un sous-ensemble des éléments, de façon à espacer progressivement les nœuds.
Par exemple, idéalement, le niveau 1 contiendrait un nœud sur deux, le niveau 2 un nœud sur quatre, et ainsi de suite (voir Figure 2).
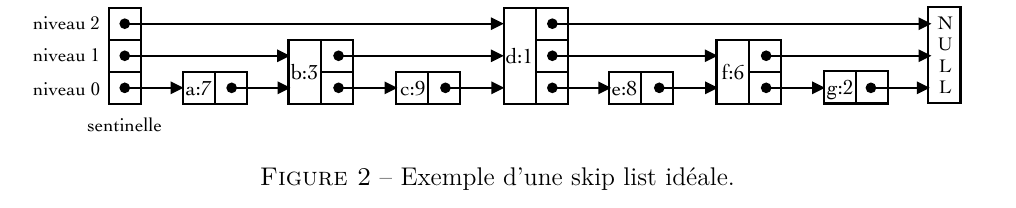
Le premier nœud de la skip list est une sentinelle : un élément spécial qui ne contient pas de donnée utile mais qui possède des pointeurs pour tous les niveaux de la liste.
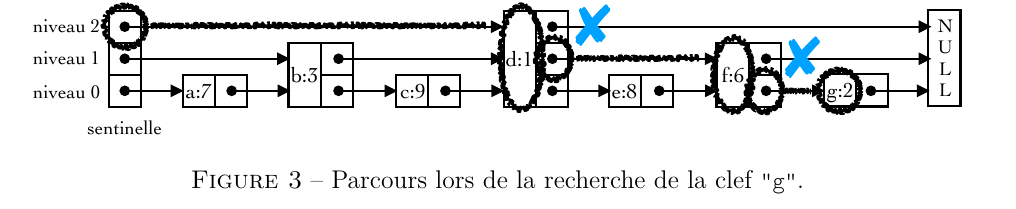
Pour chercher un élément, on démarre à partir de la sentinelle au niveau le plus élevé. À ce niveau, on suit les pointeurs vers les nœuds suivants tant que la clef du nœud actuel est inférieure à celle recherchée.
Dès qu’on rencontre un nœud dont la clef est supérieure, on descend d’un niveau et on répète la même opération.
Lorsque la recherche atteint le niveau 0, elle est terminée et, si l’élément recherché y est présent, il est renvoyé (voir Figure 3).
En pratique, chaque nœud a une probabilité de {\frac12} d’être présent dans le niveau supérieur.
3.2. Implémentation
Définition : On définit une skip list et un nœud d’une skip list par les structures suivantes :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
struct slNoeud_s { char* clef; int valeur; struct slNoeud_s* suivant_par_niveau[]; }; typedef struct slNoeud_s slNoeud; struct slListe_s { int niveau_actuel; slNoeud* sentinelle; }; typedef struct slListe_s slListe; |
On définit une constante, MAX_NIVEAU, qui correspond au nombre maximal de niveaux qu’un nœud peut avoir.
La sentinelle de la skip list est créée comme un nœud particulier, avec une clef vide, une valeur nulle, et un tableau de pointeurs de taille MAX_NIVEAU+1 (de 0 à MAX_NIVEAU inclus) tous initialisés à NULL.
La signature de la fonction est :
|
1 |
int sl_rechercher(slListe* liste, char* clef) |
Quelles sont les propriétés de la valeur renvoyée par la fonction suivante ?
|
1 2 3 4 5 6 7 |
int sl_mystere() { int niveau = 0; while ((rand() % 2) == 1 && niveau < MAX_NIVEAU) { niveau++; } return niveau; } |
On suppose que la fonction suivante est disponible :
|
1 |
slNoeud* sl_creer_noeud(int niveau, char* clef, int valeur) |
Cette fonction crée un nouveau nœud de niveau niveau avec la clef et la valeur passées en paramètre. Les pointeurs du nouveau nœud sont tous initialisés à NULL.
La fonction sl_ajoute_valeur, qui ajoute une clef et une valeur dans la skip list passée en paramètre, a la structure suivante :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 |
void sl_ajoute_valeur(slListe* liste, char* clef, int valeur) { int niveau = sl_mystere(); slNoeud* nouveau_noeud = sl_creer_noeud(niveau, clef, valeur); slNoeud* noeuds_a_mettre_a_jour[MAX_NIVEAU + 1]; slNoeud* courant = liste->sentinelle; // PARTIE A /* parcourt l’ensemble des niveaux de la liste pour trouver dans chaque niveau le noeud après lequel insérer le nouveau noeud */ // FIN PARTIE A if (niveau > liste->niveau_actuel) { // PARTIE B /* si le niveau du nouveau noeud est plus grand que le niveau actuel de la liste préparer la sentinelle */ // FIN PARTIE B } // PARTIE C /* insérer le nouveau noeud */ // FIN PARTIE C } |
Indication : Seul le code entre // PARTIE A et // FIN PARTIE A est à compléter. Il n’est pas nécessaire de recopier le code autour.
Il n’est pas nécessaire de recopier le code autour.
Il n’est pas nécessaire de recopier le code autour.
Justifier.
On considère désormais une skip list non idéale, où les éléments sont répartis de manière aléatoire avec une probabilité {p=\frac12} d’être présent dans le niveau supérieur.
On acceptera dans la suite le résultat suivant : cette espérance est proportionnelle à {\log_2(n)}.
4. Analyse syntaxique
On souhaite construire une fonction analyse qui prend en paramètre une chaîne de caractères décrivant un tableau associatif sous la forme de couples clef:valeur.
Un exemple d’utilisation pourrait être : analyse(« {id:5,valeur:12,ok:0} ») Le format de la chaîne de caractères passée en paramètre est spécifié par les règles suivantes : — la chaîne doit commencer par une accolade ouvrante, être suivie d’une liste de couples clef:valeur, et terminée par une accolade fermante, — chaque couple est composé d’une clef et d’une valeur séparées par le caractère ‘:’, — ni la clef ni la valeur ne peuvent être absentes, — la clef est une suite finie non vide de lettres minuscules (de ‘a’ à ‘z’), — la valeur est un entier non signé, sans 0 non significatif, — les couples sont séparés par le caractère ‘,’.
Le but de cette partie est d’étudier la grammaire et l’automate de ce langage de description.
Définition : On utilise la notation {x|\ldots|y} pour indiquer la disjonction de symboles allant de {x} à {y} avec {x} et {y} des chiffres ou {x} et {y} des lettres.
On considère connues les règles de production suivantes : {\begin{array}{l}N\to0|\ldots|9\\[8pt]M\to1|\ldots|9\\[8pt]L\to a|\ldots|z\end{array}}
On considère la grammaire suivante : {\begin{array}{l}T\to\{S\}\\[8pt]S\to K\mid K,S\\[8pt]K\to C:V\end{array}}
On s’autorisera à étiqueter les transitions avec des disjonctions de lettres ou de chiffres.
Dans quel état est l’automate lorsqu’on lui demande de reconnaitre la séquence {james:007} ?
A. Rappels des signatures des fonctions de
en C On rappelle les signatures et le fonctionnement de quelques fonctions de la bibliothèque standard du langage C, string.h :
|
1 |
char* strcat(char* dest, char* src) |
Concatène la chaîne src à la fin de la chaîne dest. La chaîne dest doit être suffisamment grande pour contenir le résultat.
La fonction renvoie un pointeur sur la chaîne dest.
|
1 |
int strcmp(char* c, char* d) |
Compare les deux chaînes passées en paramètres.
Elle renvoie un entier négatif si la première chaîne est inférieure à la seconde, 0 si les deux chaînes sont égales, et un entier positif si la première chaîne est supérieure à la seconde.
|
1 |
char* strcpy(char* dest, char* src) |
Copie la chaîne src dans la chaîne dest.
La chaîne dest doit être suffisamment grande pour contenir le résultat. La fonction renvoie un pointeur sur la chaîne dest.
|
1 |
size_t strlen(char* c) |
Renvoie la longueur de la chaîne passée en paramètre, c’est-à-dire le nombre de caractères avant le caractère ’\0’ de fin de chaîne.