Rappels concernant le langage Python : il n’est pas possible d’utiliser des fonctions internes à Python sur les listes ou les chaînes de caractères telles que min, max, count, remove … Seules les instructions basiques telles que len(liste), liste.append(e) sont autorisées.
Le tranchage ou slicing ainsi que la concaténation sont également permis. Les programmes doivent être commentés lorsque c’est nécessaire pour justifier les choix. Il n’est pas utile de rappeler la signature des fonctions demandées dans les différentes questions.
Introduction à deux problèmes en communication numérique
Introduction
On s’intéresse au problème de communication entre deux personnes, nommées Alice et Bob qui cherchent à s’envoyer un message au travers d’un canal de communication (une bande de fréquences radio par exemple).
Avant d’être lu par Bob, le message original d’Alice passe par plusieurs étapes que nous allons séparer de la manière suivante : — une phase de compression, durant laquelle Alice cherche à trouver la représentation la plus compacte possible du message, — une phase d’encodage durant laquelle le message compressé est transformé en une succession de symboles transmissibles au travers du canal de communication utilisé, — une phase de transmission durant laquelle le message encodé circule sur le canal de communication et est susceptible de subir une altération, — une phase de décodage durant laquelle Bob décode le message qu’il a reçu, le message lui apparaît alors sous la forme compressée, — une phase de décompression durant laquelle Bob applique l’opération réciproque de la compression opérée par Alice.
Ce modèle est décrit par le schéma de la Figure 1 :
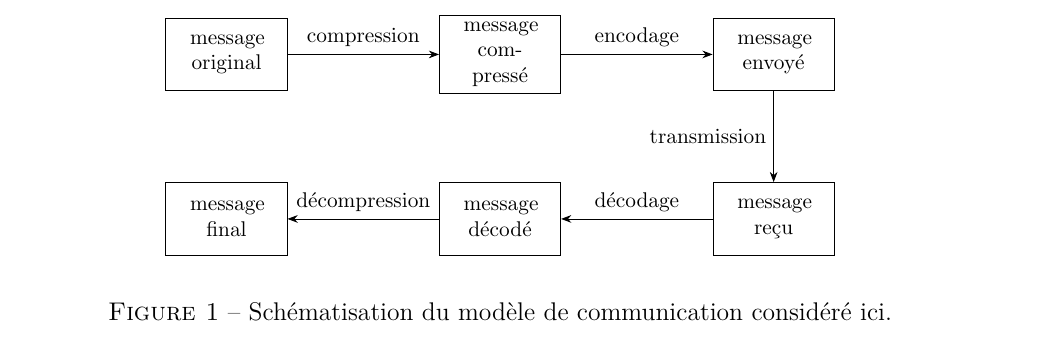
Dans cette épreuve, nous allons nous intéresser uniquement à deux phases : la compression du message d’origine par Alice en un message compact et le décodage par Bob d’un message transmis, potentiellement entaché d’erreurs.
1 Compression du message d’Alice : codage arithmétique
Le codage ASCII (American Standard Code for Information Interchange) définit une norme où 128 caractères sont codés sur 7 bits.
Ce codage est illustré par les quelques lignes suivantes :
| Caractère | Codage binaire | Équivalent numérique |
|---|---|---|
| ‘a’ | 110 0001 | 97 |
| ‘b’ | 110 0010 | 98 |
| ‘z’ | 111 1010 | 122 |
Lorsqu’une chaîne de caractères n’utilise pas l’intégralité des 128 caractères proposés par le codage ASCII, il est possible de convenir d’une représentation différente, plus économique en nombre de symboles.
Considérons la chaîne de caractères s=’abaabaca’.
On peut proposer de coder celle-ci à l’aide du tableau suivant :
| Caractère | Code |
|---|---|
| ‘a’ | 00 |
| ‘b’ | 01 |
| ‘c’ | 10 |
Dans ce cas, la chaîne de caractères s est codée sur 16 bits par : 00 01 00 00 01 00 10 00 (où des espaces ont été introduits pour faciliter la lecture).
Dans un souci de compression de l’information, il est intéressant de représenter les caractères les plus fréquents par des expressions courtes et de ne plus nécessairement coder avec des codes de longueur constante chaque caractère.
Dans l’exemple précédent, il est possible de coder le caractère ‘a’ avec 1 bit, et les caractères ‘b’ et ‘c’ avec 2 bits afin de coder la chaîne s sur seulement 11 bits en tout.
La représentation précédente emploie la même longueur pour coder les caractères ‘b’ et ‘c’ alors que le caractère ‘b’ est deux fois plus présent que le caractère ‘c’ dans la chaîne s.
Il est possible d’aller un cran plus loin et le codage arithmétique présenté dans cette étude permet un gain de compression comme s’il parvenait à représenter un caractère avec un nombre non entier de bits au prorata de sa fréquence d’apparition.
Ce principe de compression est notamment utilisé par la norme JPEG2000 de compression des images. Nous ne le présenterons cependant ici que dans le cadre de l’étude de chaînes de caractères.
1.1 Analyse du texte source
L’objet de cette partie est d’analyser le contenu d’une chaîne de caractères s afin de déterminer : — les caractères utilisés par la chaîne s ; — le nombre d’occurrences de chacun.
La fonction doit avoir une complexité linéaire en n, la longueur de la chaîne s.
|
1 2 3 4 5 6 7 8 |
def listeCaracteres(s:str): listeCar = [] n = len(s) for i in range(n): c = s[i] if not(c in listeCar): listeCar.append(c) return listeCar |
Que renvoie cette fonction lorsque s=’abaabaca’ ? Expliquer succinctement le principe de fonctionnement de cette fonction.
On négligera la complexité des append mais pas celle des tests d’appartenance de la forme i in L.
Autrement dit, la ligne 7 est considérée comme étant de complexité constante et la ligne 6 de complexité linéaire en la longueur de la liste listeCar.
|
1 2 3 4 5 6 7 |
def analyseTexte(s:str): R = [] l = listeCaracteres(s) for i in range(len(l)): c = l[i] R.append((c, nbCaracteres(c, s))) return R |
Expliquer ce que fait cette fonction et donner la valeur renvoyée par la commande analyseTexte(‘babaaaabca’).
dans s, (autrement dit k est la longueur de listeCaracteres(s)), donner une estimation de la complexité asymptotique dans le pire des cas de la fonction analyseTexte.
De plus, cette fonction devra impérativement ne parcourir qu’une seule fois la chaîne de caractères. On admettra qu’un test d’appartenance d’une clé à un dictionnaire se fait à coût constant.
Par exemple, analyseTexte(‘abracadabra’) renverra {‘a’:5, ‘b’:2, ‘r’:2, ‘c’:1, ‘d’:1}.
1.2 Exploitation d’analyses existantes
On peut éviter de réaliser une analyse de la chaîne de caractères à coder en exploitant des données statistiques disponibles.
La numérisation de larges corpus littéraires a permis la création de bases de données contenant des informations relatives au nombre d’occurrences des différents caractères alphanumériques dans diverses langues.
Nous allons supposer disposer d’une base de données constituée de trois tables (les clefs primaires sont soulignées) : — caractere(idCar, symbole, typeCaractere, codeHTML) ; — corpus(idLivre, titre, auteur, annee, nombreCaracteres, langue) ; — occurrences(idCar, idLivre, nombreOccurrences) ; dont voici quelques extraits :
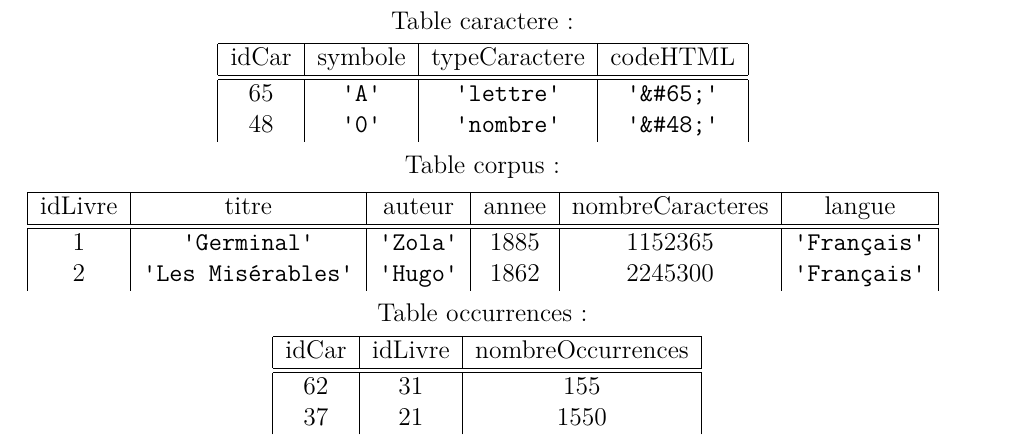
devra renvoyer une table à deux attributs : une colonne contenant le symbole de chaque caractère, et une autre colonne contenant le rapport entre le nombre total d’occurrences du caractère et le nombre total de caractères des textes de tout le corpus.
1.3 Compression
La compression par codage arithmétique consiste à représenter une chaîne de caractères s par un nombre réel déterminé à l’intérieur de l’intervalle [0; 1[. Initialement, on attribue à chaque caractère utile une portion de l’intervalle [0; 1[ proportionnelle à sa fréquence d’occurrences.
Par exemple, pour un alphabet à 5 lettres ‘abcde’, on pourrait avoir un tableau comme ci-dessous :
| Caractère | ‘a’ | ‘b’ | ‘c’ |
|---|---|---|---|
| Fréquence | 0.2 | 0.1 | 0.2 |
| Intervalle | {[0;0.2[} | {[0.2;0.3[} | {[0.3;0.5[} |
| Caractère | ‘d’ | ‘e’ |
|---|---|---|
| Fréquence | 0.4 | 0.1 |
| Intervalle | {[0.5;0.9[} | {[0.9;1[} |
La chaîne de caractères s est codée en partant de l’intervalle [0; 1[.
À chaque caractère successif de celle-ci, on affine cet intervalle en ne considérant que la portion correspondant au caractère lu.
Si par exemple la chaîne à coder est s = ‘dac’ : — on obtient d’abord l’intervalle [0.5; 0.9[ correspondant au caractère ‘d’ ; — le caractère ‘a’ détermine alors le sous-intervalle [0.50; 0.58[ de [0.5; 0.9[ correspondant à la portion associée au caractère ‘a’. — le caractère ‘c’ détermine enfin l’intervalle [0.524; 0.540[.
La figure qui suit illustre ce processus.
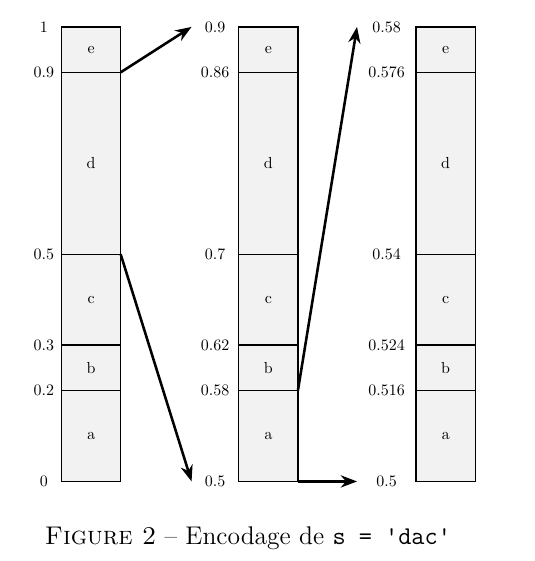
On suppose disposer d’une fonction codeCar(car:str,g:float,d:float)->(float,float) qui prend en argument un caractère car et les deux extrémités d’un intervalle [g, d[ et qui renvoie un tuple composé des extrémités du sous-intervalle de [g, d[ déterminé par le caractère car.
En reprenant l’illustration précédente codeCar(‘b’,0,1) produit (0.2,0.3) et codeCar(‘a’,0.5,0.9) produit (0.5,0.58).
Le codage arithmétique consiste alors à coder la chaîne s par un flottant x choisi arbitrairement à l’intérieur de l’intervalle [g, d[.
1.4 Décodage
Pour effectuer le décodage d’un flottant x, il suffit de repérer dans quelle succession d’intervalles celui-ci se trouve.
À titre d’exemple, reprenons le tableau précédent et considérons le nombre x=0.123
| Caractère | ‘a’ | ‘b’ | ‘c’ |
|---|---|---|---|
| Fréquence | 0.2 | 0.1 | 0.2 |
| Intervalle | {[0;0.2[} | {[0.2;0.3[} | {[0.3;0.5[} |
| Caractère | ‘d’ | ‘e’ |
|---|---|---|
| Fréquence | 0.4 | 0.1 |
| Intervalle | {[0.5;0.9[} | {[0.9;1[} |
Puisque x appartient à l’intervalle [0; 0.2[, le premier caractère est un ‘a’.
Puisque x appartient au sous-intervalle [0.10; 0.18[, le caractère suivant est un ‘d’, etc.
Expliquer par une phrase ce qui est à l’origine de cette ambiguïté.
Une solution possible pour résoudre le problème précédent consiste à introduire un caractère nouveau signifiant la fin de la chaîne de caractères. Nous conviendrons de désigner ce caractère par ‘#’. Ce caractère se voit attribuer une plage non vide au voisinage de 0.
Dans la suite, on suppose que la table des fréquences est adaptée de sorte à prendre en compte la présence de ce nouveau caractère.
On suppose disposer, en plus de la fonction codeCar(car,g,d) précédente, d’une fonction decodeCar(x:float,g:float,d:float)->str qui détermine le caractère correspondant à la valeur x quand celle-ci est comprise dans la plage de [g, d[.
Par exemple decodeCar(0.123,0,1) donne ‘a’ tandis que decodeCar(0.123,0,0.2) donne le caractère ‘d’.
Le codage précédent ne fonctionne que sous l’hypothèse illusoire d’exactitude des calculs jusqu’à une très grande précision.
Cette précision est cependant limitée par la taille de la mantisse représentant un réel et il ne peut être mis en œuvre sous la forme précédente qu’avec des chaînes relativement courtes.
Pour résoudre cette difficulté, on adopte un codage en arithmétique entière : au lieu de considérer un intervalle flottant [0, 1[, c’est un intervalle entier {\{000,\ldots,999\}} qui est utilisé. Cette technique ne sera pas abordée dans le cadre de cette épreuve de durée limitée.
2 Décodage du message reçu par Bob à l’aide de
l’algorithme de Viterbi
2.1 Modélisation du canal de communication par un graphe
Dans cette partie, nous allons désormais considérer que le message compressé par Alice a été envoyé au travers d’un canal de communication.
À cette fin, et indépendamment de la phase de compression étudiée dans la première partie, le message a subi une deuxième phase de transformation, dite d’encodage (cf Figure 1). Le message envoyé sur le canal est une suite de symboles à valeurs dans un alphabet, noté {\Sigma}, comportant K symboles.
Le choix d’un alphabet efficace n’est pas l’objet de notre étude et constitue un sujet à part entière.
Suite au passage dans le canal de communication, le message envoyé subit une altération de sorte que Bob reçoit une séquence de symboles de {\Sigma} qui ne correspond pas nécessairement à celle qui a été émise.
Dans cette partie, nous allons voir une approche permettant à Bob de décoder le message reçu et de potentiellement corriger quelques erreurs liées à la transmission du message et à la connaissance a priori de la propension du canal de communication à altérer les symboles du message lors de la transmission.
La modélisation proposée est la suivante : — Bob observe une suite de N symboles {\mathrm{obs}_0,\ldots,\mathrm{obs}_{N-1}}, que nous allons représenter par une liste Python {\mathrm{Obs}=[\mathrm{obs}_0,\ldots,\mathrm{obs}_{N-1}]}, — pour simplifier, on supposera que l’alphabet {\Sigma} est un ensemble de K entiers consécutifs commençant à 0, de sorte que {\Sigma=\{0,\ldots,K-1\}}.
Par exemple si K = 3 et N = 8, un message valide reçu par Bob pourrait être [2,0,0,2,1,1,0,0]. — chacun des symboles observés {\mathrm{obs}_t} correspond à l’altération d’un symbole {s_t} envoyé par Alice.
On note {[s_0,\ldots,s_{N-1}]} le message original ; pour reprendre l’exemple précédent, Alice pourrait avoir envoyé [2,0,0,2,1,1,2,0]. — on connaît, pour chaque paire {(i,j)\in \Sigma^2}, la probabilité {E_{i,j}} que le canal altère le symbole j en un symbole i.
On stocke ces probabilités dans une liste de listes E ; autrement dit, E[i][j] est la probabilité conditionnelle d’observer le symbole i sachant que le symbole j a été émis.
Ici (par exemple) on pourrait considérer : {E=\begin{pmatrix}0.7&0.2&0.3\\[8pt]0.2&0.7&0.1\\[8pt]0.1&0.1&0.6\end{pmatrix},} représentée par la liste de listes : E = [[0.7,0.2,0.3],[0.2,0.7,0.1],[0.1,0.1,0.6]].
Le fait que E[2][0] vaille 0.1 signifie donc que la probabilité que le symbole observé par Bob soit un 2 sachant qu’Alice a émis un 0 est de 0.1. — on suppose également que le symbole courant {s_t} envoyé par Alice a une incidence sur le symbole suivant {s_{t+1}} qu’elle peut envoyer, au même titre que dans une langue comme le français, la probabilité d’observer un ‘t’ dans un mot, n’est pas la même suivant que le caractère précédent est un ‘e’ ou un ‘z’.
Ainsi pour chaque couple de symboles {(i,j)\in \Sigma^2}, on suppose que l’on connaît la probabilité d’émettre le symbole j à l’instant t + 1 sachant que symbole i a été émis à l’instant t. On suppose également que cette probabilité ne dépend pas de t.
L’information concernant ces probabilités de transition d’un symbole à l’autre peut se stocker dans une matrice P de taille {K\times K}, que l’on représente informatiquement par une liste de listes P.
Chaque entrée P[i][j] donne la probabilité qu’Alice émette le symbole j à l’instant t + 1 sachant qu’elle a émis le symbole i à l’instant t. En d’autres termes, {P[i][j]=\mathbb P_{s_t=i}(s_{t+1}=j)}. On prendra ici à titre d’exemple : {P=\begin{pmatrix}0.3&0.2&0.5\\[8pt]0.4&0.4&0.2\\[8pt]0.2&0.3&0.5\end{pmatrix},} représentée par la liste de listes : P=[[0.3,0.2,0.5],[0.4,0.4,0.2],[0.2,0.3,0.5]].
Le fait que P[2][0] vaille 0.2 signifie donc que la probabilité que le symbole envoyé par Alice à l’instant t + 1 soit un 0 sachant que celui envoyé à l’instant t est un 2 vaut 0.2.
Nous allons désormais nous intéresser au problème du décodage : étant donné la liste {\mathrm{Obs}=[\mathrm{obs}_0,\ldots,\mathrm{obs}_{N-1}]} des symboles observés par Bob, quelle séquence {\widetilde s_0,\ldots,\widetilde s_{N-1}} est la plus probable ?
En d’autres termes, {\widetilde s_0,\ldots,\widetilde s_{N-1}} est l’estimation la plus probable faite par Bob du message d’origine {s_0,\ldots,s_{N-1}}, étant donné les observations {\mathrm{obs}_0,\ldots,\mathrm{obs}_{N-1}}.
La modélisation précédente peut se représenter à l’aide d’un graphe défini comme suit (voir Figure 3 pour un exemple) : — on crée un sommet {S_{i,j}} pour chaque symbole possible {0\le i\le K-1} et chaque indice d’observation {0\le j\le N-1}.
Chaque couche verticale dans le graphe correspond à un caractère dans le message.
Chaque strate horizontale correspond à un symbole. — au niveau de la j-ème couche verticale, les sommets {S_{i,j}} pour {j\lt N-1} ont pour successeurs les états {S_{k,j+1}} pour tous les symboles {k} possibles, — par commodité, on ajoute un état source {\sigma} correspondant au début du message décodé et un état cible {\tau} correspondant à la fin du message, ces états étant respectivement reliés à la première et la dernière couche, — le décodage du message envoyé par Alice correspond à un chemin entre {\sigma} et {\tau} dans ce graphe.
A chaque sommet du chemin correspond une lettre décodée. Par exemple, le chemin passant par {S_{0,0},S_{2,1},S_{0,2},S_{1,3}}, correspond au décodage de [0, 2, 0, 1].
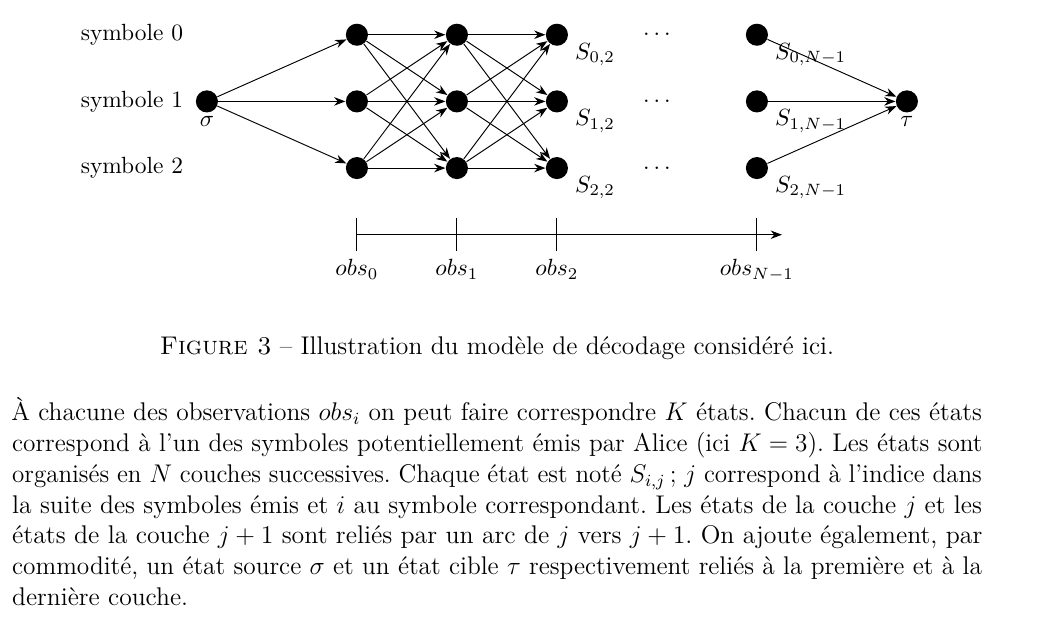
On ne comptera pas les sommets source {\sigma} et cible {\tau} , ni les arcs partant du sommet source {\sigma} ni ceux arrivant à la cible {\tau} .
On choisit désormais de pondérer chaque arc par la probabilité de transiter par cet arc. Autrement dit : — les arcs issus de la source {\sigma} vers {S_{i,0}} sont pondérés par {E_{\mathrm{obs}_0,i}} la probabilité d’observer le symbole {\mathrm{obs}_0} sachant que le symbole {i} a été émis par Alice ;
— les arcs arrivant à la cible {\tau} sont pondérés par 1 (en fin de message, on transite forcément vers l’état final), — les arcs internes entre {S_{i,j}} et {S_{k,j+1}} sont pondérés par la probabilité {E_{\mathrm{obs}_{j+1},k}P_{i,k}}.
La probabilité d’un chemin {\sigma S_{i_0,0}S_{i_1,1}\ldots S_{i_{N-1},N-1}\tau} entre {\sigma} et {\tau} est le produit des probabilités des arcs qui le composent. L’objectif va être de trouver le chemin de probabilité maximale dans ce graphe entre le sommet source {\sigma} et le sommet cible {\tau} .
Les arcs entre les sommets devront être pondérés par les probabilités correspondantes.
Préciser si un algorithme d’exploration exhaustive est envisageable dans ce cas.
2.2 Stratégie gloutonne
Pour pouvoir implémenter correctement la recherche du chemin de probabilité maximale, il est utile de disposer d’une fonction auxiliaire qui sera utilisée dès que nécessaire.
Proposer une fonction maximumListe(liste:[float])->(float,int) qui prend en entrée une liste de nombres et qui renvoie la valeur du maximum de la liste ainsi que le plus petit argument du maximum, i.e. le premier indice auquel cette valeur maximale apparaît.
On souhaite appliquer un algorithme glouton pour trouver le chemin de probabilité maximale entre le sommet source {\sigma} et le sommet cible {\tau} . On rappelle qu’un algorithme glouton cherche, à chaque étape, à faire le choix localement optimal.
Ici, si à une étape on se retrouve au sommet {S_{i,j}}, il s’agit de choisir l’arc de plus forte probabilité partant de ce sommet.
Dans un premier temps on écrit une fonction initialiserGlouton(Obs:[[int]], E:[[float]], K:int)->int qui permet d’initialiser l’algorithme glouton en trouvant le sommet le plus probable parmi {S_{i,0}} pour {i} variant entre 0 et K − 1.
Pour cela il faut regarder la colonne Obs[0] de E et relever l’indice de la plus grande valeur.
|
1 2 3 4 |
def initialiserGlouton(Obs, E, K): probasInitiales = [E[Obs[0][i]] for i in range(K)] s, symbole = maximumListe(probasInitiales) return symbole |
Même si cela n’est pas nécessaire, K, N seront des arguments de cette fonction.
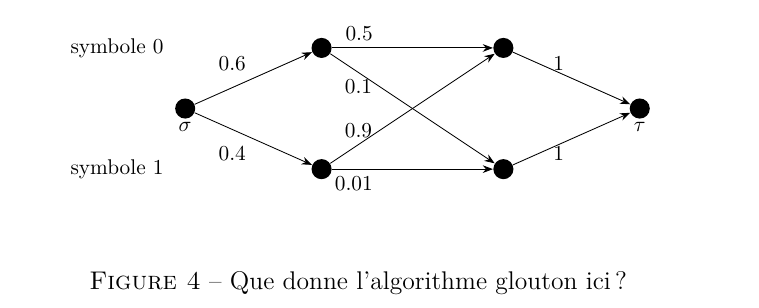
Conclure quant à l’optimalité de l’approche.
2.3 Stratégie de programmation dynamique
Préciser alors quel algorithme pourrait être utilisé.
Les algorithmes évoqués à la question précédente ne sont cependant pas optimaux dans ce cas. L’algorithme optimal est dû à Andrew Viterbi et date de 1967. Il repose sur le paradigme de la programmation dynamique. On appelle {T_{i,j}} la valeur de probabilité maximale entre la source et l’état {S_{i,j}}.
On peut alors établir l’équation de programmation dynamique suivante : {\begin{array}{l}T_{i,j}=\max_{0\le k\le K-1}(T_{k,j-1}P_{k,i}E_{\mathrm{obs}_j,i})\\[4pt]\qquad\text{si }N-1\ge j>0,\\[8pt]T_{i,0}=E_{\mathrm{obs}_0,i}.&\end{array}} Comme on cherche également à obtenir la valeur des états correspondant au chemin optimal, on maintient également le tableau des prédécesseurs suivant : {\begin{array}{l}\operatorname{argT}_{i,j}=\mathop{\rm arg\,max}_{0\le k\le K-1}(T_{k,j-1}P_{k,i}E_{\mathrm{obs}_j,i})\\[8pt]\text{si }N-1\ge j>0,\\[8pt]\operatorname{argT}_{i,0}=-1.\end{array}} La valeur −1 du deuxième tableau est purement conventionnelle et ne sert qu’à représenter l’état source {\sigma} qui ne correspond pas à une observation.
On suppose avoir codé une fonction initialiserViterbi(E:[[float]], Obs0:int, K:int, N:int)->([[float]],[[int]]) qui prend en entrée la matrice E d’émission, la valeur de la première observation Obs0, le nombre d’éléments K de {\Sigma}, le nombre d’observations N et qui renvoie deux tableaux (liste de listes) T et argT vérifiant les caractéristiques suivantes : — T et argT sont de dimensions K lignes par N colonnes, — T[i][0] contient la valeur de {E_{\mathrm{obs}_0,i}}, — argT[i][0] contient la valeur −1, — les autres valeurs de T et argT sont à 0.
En voici une implémentation possible :
|
1 2 3 4 5 6 7 8 |
def initialiserViterbi(E, Obs0, K, N): probasInitiales = [E[Obs0][i] for i in range(K)] T = [[0 for j in range(N)] for i in range(K)] argT = [[0 for j in range(N)] for i in range(K)] for i in range(K): T[i][0] = probasInitiales[i] argT[i][0] = -1 return T, argT |
donne les tableaux T et argT suivants. Indiquer la séquence d’états la plus probable.
| j | T[0][j] | T[1][j] | T[2][j] | argT [0][j] |
argT [1][j] |
argT [2][j] |
|---|---|---|---|---|---|---|
| 0 | 0.1 | 0.1 | 0.6 | -1 | -1 | -1 |
| 1 | 0.084 | 0.036 | 0.09 | 2 | 2 | 2 |
| 2 | 0.018 | 0.0054 | 0.014 | 0 | 2 | 0 |
| 3 | 0.00053 | 0.00041 | 0.0053 | 0 | 2 | 0 |
| 4 | 0.00021 | 0.0011 | 0.00026 | 2 | 2 | 2 |
| 5 | 8.9e-05 | 0.00031 | 2.2e-05 | 1 | 1 | 1 |
| 6 | 8.7e-05 | 2.5e-05 | 1.9e-05 | 1 | 1 | 1 |
| 7 | 1.8e-05 | 3.5e-06 | 1.3e-05 | 0 | 0 | 0 |