Préliminaires
L’épreuve est composée d’un problème unique, comportant 38 questions. Le problème est divisé en quatre sections qui peuvent être traitées séparément, à condition de lire toutes les définitions de la section 1.
Dans la première section (page 1), nous introduisons la complexité de Kolmogoroff et étudions des propriétés de calculabilité. Dans la deuxième section (page 3), nous estimons la complexité de Kolmogoroff à l’aide du codage de Huffman.
La troisième section (page 4) contient des prolégomènes pour la section suivante. Dans la quatrième section (page 5), nous nous appuyons sur un modèle de calcul épuré, introduit à travers plusieurs langages formels, afin toujours d’estimer la complexité de Kolmogoroff.
Dans tout l’énoncé, un même identificateur écrit dans deux polices de caractère différentes désigne la même entité, mais du point de vue mathématique pour la police en italique (par exemple n, D ou π) et du point de vue informatique pour celle en romain avec espacement fixe (par exemple n, d ou pi).
Travail attendu
Pour répondre à une question, il est permis de réutiliser le résultat d’une question antérieure, même sans avoir réussi à établir ce résultat.
Il faudra coder des fonctions à l’aide du langage de programmation OCaml exclusivement, en reprenant l’en-tête de fonctions fourni par le sujet, sans s’obliger à recopier la déclaration des types.
Il est permis d’utiliser la totalité du langage OCaml mais il est recommandé de s’en tenir aux fonctions les plus courantes afin de rester compréhensible. Des rappels ponctuels de documentation du langage OCaml peuvent être proposés à titre d’aide.
Quand l’énoncé demande de coder une fonction, sauf demande explicite de l’énoncé, il n’est pas nécessaire de justifier que celle-ci est correcte ou de tester que des préconditions sont satisfaites.
Le barème tient compte de la clarté des programmes : nous recommandons de choisir des noms de variables intelligibles ou encore de structurer de longs codes par des blocs ou par des fonctions auxiliaires dont on décrit le rôle.
1 Complexité de Kolmogoroff
Nous notons {\Sigma} l’ensemble ordonné des 256 caractères ASCII étendus usuels et {\Sigma^\ast} l’ensemble des chaînes de caractères. Pour toute chaîne de caractères {x\in \Sigma^\ast}, la longueur de x, notée |x|, est le nombre de caractères qui la composent. Par exemple, la longueur de la chaîne « abac » est 4.
Le nombre d’occurrences d’un symbole {\sigma\in \Sigma} dans une chaîne de caractères {x\in \Sigma^\ast} est noté {|x|_\sigma}. Par exemple, {|\mathrm{abac}|_a=2}.
Dans l’ensemble du sujet, nous nous appuyons sur une machine universelle, c’est-à-dire une fonction OCaml eval, de type string -> string, telle que : — si la chaîne x, de type string, est le code source d’une expression OCaml y de type string et si l’exécution du code x se termine sans erreur, alors eval x se termine et a pour valeur de retour la valeur de y ; — sinon, eval x ne se termine pas.
Les exécutions de eval ont lieu sur une machine idéale dont la mémoire est infinie et qui est capable de gérer des types natifs de taille quelconque.
Définition : Pour toute chaîne de caractères {y\in \Sigma^\ast}, nous disons que la chaîne de caractères {x\in \Sigma^\ast} est une description de la chaîne y si le calcul eval x se termine et renvoie la chaîne y.
Nous appelons complexité de Kolmogoroff de y et notons K(y) la longueur de la plus courte chaîne de caractères {x\in \Sigma^\ast} qui décrit y. L’objet de ce sujet est d’étudier des propriétés et diverses majorations de la complexité de Kolmogoroff.
Dans toutes nos illustrations, nous nous concentrons sur la description de la chaîne de caractères {y_0=\text{«1000000…»}\in\Sigma^\ast}, qui correspond à l’entier {10^{(10^{10})}} écrit en base 10 et que nous fixons une fois pour toutes.
1.1 Un premier exemple
Indication OCaml : Il est rappelé que la fonction string_of_int convertit un entier en une chaîne de caractères.
|
1 2 |
let exp10 n = (* Calcul de 10^n a ecrire *) in string_of_int (exp10 (exp10 10)) |
afin d’en faire une description de la chaîne de caractères {y_0=\text{«1000000…»}}.
En déduire une nouvelle borne grossière (à {10^2} près) de la complexité de Kolmogoroff {K(y_0)}, significativement meilleure que celle de la question 1.
1.2 Quelques propriétés
Indication OCaml : L’expression String.make (n : int) (sigma : char) : string désigne la chaîne de caractères répétant n fois le caractère {\sigma\in \Sigma}. Pour tout entier n compris entre 0 et 255, Char.chr (n : int) : char désigne le ne caractère dans la numérotation ASCII.
En écrire le code sous la forme d’une fonction OCaml phi (n : int) : string.
Nous prétendons avoir écrit une fonction OCaml kolmogoroff (y : string) : int qui calcule la complexité de Kolmogoroff K(y).
kolmogoroff.Définition : Nous appelons décompresseur toute fonction OCaml d : string -> string.
Pour toute chaîne de caractères {y\in \Sigma^\ast} et pour tout décompresseur D (noté informatiquement d), nous disons que la chaîne de caractères z est une description de la chaîne y par rapport à D si le calcul eval (d z) se termine sans erreur et a pour valeur de retour y.
Nous appelons complexité de Kolmogoroff par rapport à D de la chaîne y, et notons {K_D(y)}, la longueur de la plus courte chaîne de caractères {z\in \Sigma^\ast} qui décrit y par rapport à D.
2 Estimation de la complexité grâce au décompresseur de Huffman
Nous fixons dans cette section la chaîne de caractères {x_0\in\Sigma^\ast} suivante
|
1 |
"let rec t e=if e=0 then 1 else let n=e-1 in 10*t n in let n=t 10 in t n" |
. La chaîne {x_0} contient 71 caractères, l’espace étant un caractère et les guillemets ne faisant pas partie de la chaîne.
Indication OCaml : Nous rappelons le détail de quelques fonctions du module OCaml Hashtbl permettant de manipuler des dictionnaires (ou tableaux associatifs) mutables. — Hashtbl.create (n : int) : (’a, ’b) Hashtbl.t crée un dictionnaire vide de taille initiale n. — Hashtbl.add (d : (’a, ’b) Hashtbl.t) (k : ’a) (v : ’b) : unit ajoute une association entre la clé k et la valeur v au dictionnaire d. — Hashtbl.find_opt (d : (’a, ’b) Hashtbl.t) (k : ’a) : ’b option vaut Some v si le dictionnaire d possède une association entre la clé k et la valeur v et vaut None sinon.
Nous exécutons count x0 et obtenons le dictionnaire suivant :
|
1 2 |
Caractère : n t i l 1 c f h r s - * 0 = e espace Effectif : 8 8 4 4 4 1 1 1 1 1 1 1 3 4 10 19 |
Nous appelons {z_0} la chaîne de bits correspondant à la compression de la chaîne {x_0} par l’algorithme de Huffman.
Nous notons H le décompresseur qui utilise l’arbre de Huffman de la question 13 pour transformer une chaîne de bits {z\in\{0,1\}^*} en un mot {x\in \Sigma^\ast} et renvoie la chaîne de caractères « string_of_int (x) ».
En déduire que la complexité de Kolmogoroff de {y_0=10000\ldots} par rapport au décompresseur {H} vérifie {K_H(y_0)\le239.}
3 Interlude
Nous souhaitons écrire une fonction new_string : unit -> string ainsi spécifiée : à chaque appel, une chaîne de caractères inédite est produite. Nous offrons trois propositions de code.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
let inc s = s := "a" ^ (!s); !s (* Commun aux 3 propositions *) let new_string1 = (* Proposition 1 *) let seed1 = ref "#" in fun () -> inc seed1 let new_string2 () = (* Proposition 2 *) let seed2 = ref "#" in inc seed2 let seed3 = ref "#" (* Proposition 3 *) let new_string3 () = inc seed3 |
Écrire un test qui permet de discriminer la fonction erronée.
Expliquer.
4 Estimation de la complexité grâce au décompresseur de De Bruijn
Nous nous avisons que la complexité de Kolmogoroff est influencée par la verbosité et l’expressivité du langage de programmation.
Dans cette section, nous tentons de réduire l’encombrement ou la facilité d’écriture dus à la syntaxe du langage OCaml en introduisant un modèle de calcul nouveau et épuré.
4.1 Construction syntaxique d’un langage
Nous présentons systématiquement les grammaires sous la forme d’un quadruplet {(N,\Gamma,S,\Pi)} où N désigne l’alphabet des symboles non terminaux, {\Gamma} l’alphabet des symboles terminaux, {S\in N} le symbole initial et {\Pi} l’ensemble des règles de production, de la forme {X\to\gamma} avec {X\in N} et {\gamma\in(N\cup\Gamma)^*}.
Une dérivation immédiate se note {\alpha\Rightarrow\beta}, avec {(\alpha,\beta)\in((N\cup\Gamma)^\ast)^2}, et indique qu’il existe une règle de production {X\to\gamma} de {\Pi} et des décompositions {\alpha=\alpha_1X\alpha_2} et {\beta=\alpha_1\gamma\alpha_2}, avec {(\alpha_1,\alpha_2)\in((N\cup\Gamma)^\ast)^2}. Une dérivation se note {\Rightarrow^\ast} et indique l’existence d’une suite finie, éventuellement vide, de dérivations immédiates.
Enfin, le langage engendré par une grammaire {G} se note {L(G)} et désigne l’ensemble des mots de {\Gamma^\ast} qui dérivent du symbole initial {S}.
Selon les questions, nous représentons les mots de {\Gamma} par le type char list ou le type string. Soit {G_0} la grammaire {(\{V\},\{a,b,\#\},V,\Pi_0)} dont les règles de production sont {\Pi_0:V\to aV\mid bV\mid\#.}
Valeur de retour : Couple (v, s) où le préfixe v est représenté par le type string et s est le suffixe restant.
Effet : Une exception SyntaxError est levée si la pré-condition n’est pas satisfaite.
Soit {G_1} la grammaire {(\{T\},\{(,\textunderscore ,)\},T,\Pi_1)} dont les règles de production sont {\Pi_1:T\to(TT)\mid\text{\textunderscore }.}
On pourra, par exemple, raisonner par induction structurelle sur le nombre de parenthèses ouvrantes et fermantes qui se trouvent dans un préfixe d’un mot de {L(G_1)}.
Soit {G_2} la grammaire {(\{T\},\{\mathrm{var},(,),\text{->}\},T,\Pi_2)} dont les règles de production sont {\Pi_2:T\to\mathrm{var}\mid(TT)\mid\mathrm{var}\text{->}T.}
Soit finalement {G} la grammaire {(\{T,V\},\{a,b,\#,(,),\text{->}\},T,\Pi)} dont les règles de production sont {\Pi:\left\{\begin{array}{l}T\to V\mid(TT)\mid V\text{->}T\\[8pt]V\to aV\mid bV\mid\#.\end{array}\right.} Nous admettons que la grammaire G n’est pas ambiguë. Nous appelons variable les mots de {L(G_0)}.
Informellement, la grammaire {G} engendre un langage {L(G)} qui permet de parler de variables, d’applications d’une expression à une autre et de fonctions. Il nous reste à en construire une sémantique, ce qui sera fait en section 4.3.
Afin de représenter l’arbre d’analyse d’un mot du langage L(G), nous introduisons le type ada par la déclaration suivante.
|
1 |
type ada = V of string | A of (ada * ada) | F of (string * ada) |
Nous notons A l’ensemble des arbres d’analyse.
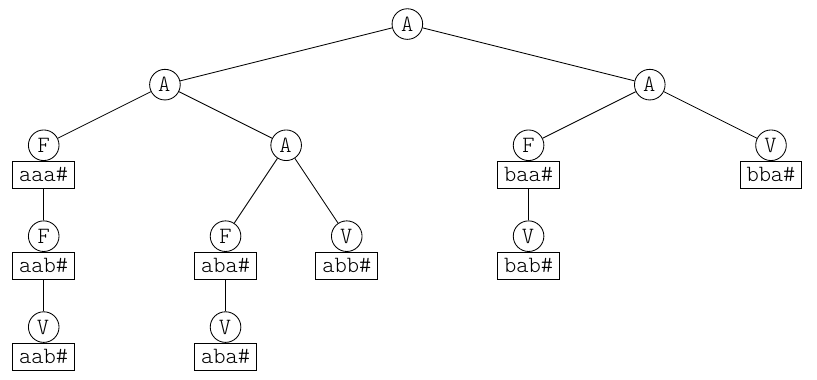
Le constructeur OCaml V représente les dérivations immédiates de règle {T\to V} et introduit les feuilles ; le constructeur OCaml A représente les dérivations immédiates de règle {T\to(T\ T)} et introduit des nœuds internes d’arité 2 ; le constructeur OCaml F représente les dérivations immédiates de règle V ->T et introduit des nœuds internes d’arité 1.
Les dérivations à partir du symbole non terminal V sont directement représentées par une valeur OCaml de type string. Par exemple, le mot ((aaa#->aab#->aab#(aba#->aba#abb#))(baa#->bab#bba#)) appartient à {L(G)} admet pour arbre d’analyse :
Valeur de retour : Couple (a, s) où a est l’arbre d’analyse de p et s est le suffixe restant. Effet : Une exception SyntaxError est levée si la pré-condition n’est pas satisfaite.
Indication OCaml : Nous supposons définie une fonction charlist_of_string : string -> char list qui transforme une chaîne de caractères en une liste de caractères.
Définition : Pour tout entier naturel {n\in\mathbb N}, nous définissons le mot de {\in L(G)}: {\lceil n\rceil=\text{b\#->a\#->(b\#(b\#…(b\#(b\#a\#))…))}} où la variable b# apparaît {n} fois à droite des deux symboles ->.
Définition : Plus généralement, nous disons qu’un mot {w} de {L(G)} incarne un entier naturel {n\in\mathbb N} s’il existe deux variables distinctes {v_1} et {v_2} dans {L(G_0)} telles que {w} est de la forme {w=v_2\text{->}v_1\text{->}(v_2(v_2\ldots(v_2(v_2v_1))\ldots))\in L(G)}où la variable {v_2} apparaît {n} fois à droite des deux symboles ->.
Si un tel entier n’existe pas, une exception SyntaxError est levée.
4.2 Réécriture des variables et sérialisation
Indication OCaml : Nous supposons définis un module OCaml StringSet permettant de construire des ensembles de chaînes de caractères persistants, de type StringSet.t, et des fonctions :
— StringSet.mem : string -> StringSet.t -> bool qui teste l’appartenance d’un élément à un ensemble.
— StringSet.remove : string -> StringSet.t -> StringSet.t qui retourne un ensemble privé d’un élément.
— StringSet.singleton : string -> StringSet.t qui construit un singleton à partir d’un élément.
— StringSet.union : StringSet.t -> StringSet.t -> StringSet.t qui construit l’union de deux ensembles.
Définition : L’ensemble des variables libres {\mathrm{VL}(a)\subseteq\Sigma^\ast} d’un arbre d’analyse {a\in\mathcal A} est défini par induction structurelle avec les règles d’inférence suivantes :
— si l’arbre d’analyse {a} est de la forme V v, où {v\in L(G_0)}, alors {\mathrm{VL}(a)} est le singleton {\{v\}} ;
— si l’arbre d’analyse {a} est de la forme A (a1,a2), où {a_1} et {a_2} sont deux arbres d’analyse, alors {\mathrm{VL}(a)} est la réunion {\mathrm{VL}(a_1)\cup\mathrm{VL}(a_2)} ;
— si l’arbre d’analyse {a} est de la forme F (v,a1), où {v\in L(G_0)} et {a_1} est un arbre d’analyse, alors {\mathrm{VL}(a)} est l’ensemble {\mathrm{VL}(a_1)\setminus\{v\}}.
Définition : Un arbre d’analyse est dit clos s’il ne contient pas de variables libres ; de même, un mot de L(G) est dit clos si son arbre d’analyse est clos.
Dans un arbre d’analyse clos {a\in\mathcal A} , pour toute chaîne de caractères {v\in L(G_0)}, si la construction OCaml V v apparaît comme feuille de l’arbre a, alors il existe un nœud interne de la forme F (v,_) parmi les ascendants de V v qui coïncide avec l’« introduction » de la variable v.
Afin de ne plus s’encombrer avec des variables nommées par une chaîne de caractères, nous adoptons une nouvelle représentation des mots du langage L(G) sous forme d’un arbre, appelé terme de De Bruijn.
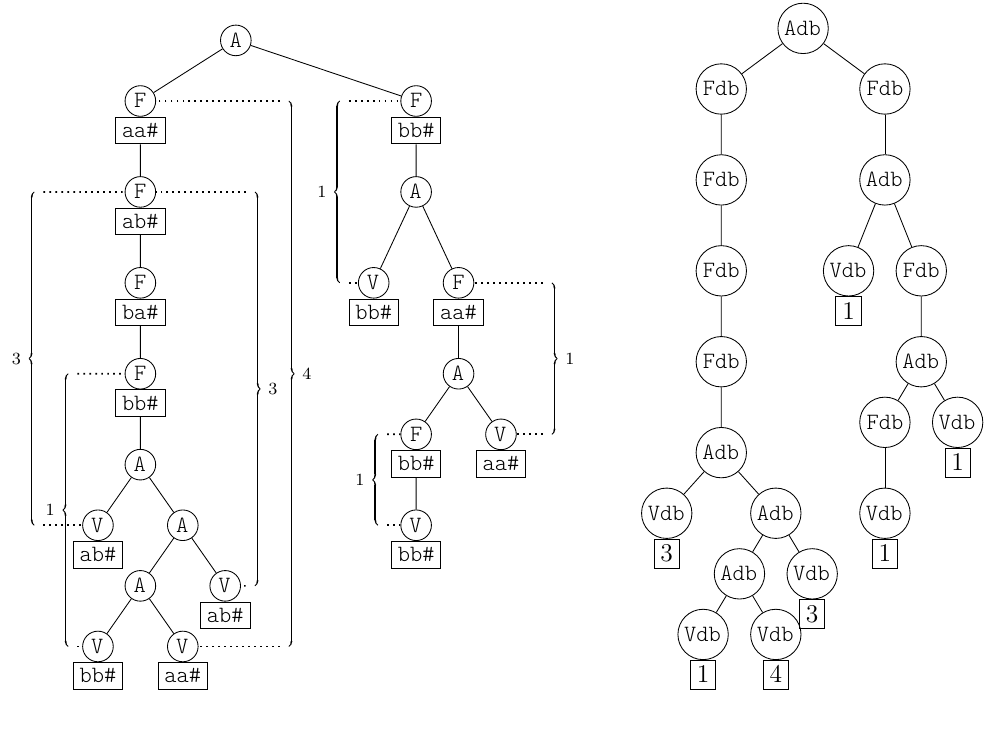
Définition : Un terme de De Bruijn s’obtient à partir d’un arbre d’analyse {a\in\mathcal A} en remplaçant toute feuille de l’arbre a, disons V v avec {v\in L(G_0)}, par une feuille étiquetée par l’entier {u=1+\ell}, où {\ell\in\mathbb N} est le nombre de nœuds internes de la forme F (v’,_) avec {v^{\prime}\in L(G_0)\setminus\{v\}}, qui existent entre ladite feuille V v et le plus proche nœud interne de la forme F (v,_) parmi ses ascendants dans l’arbre d’analyse a.
Nous déclarons un nouveau type
|
1 |
type tdb = Vdb of int | Adb of (tdb * tdb) | Fdb of tdb |
Nous notons T l’ensemble des termes de De Bruijn. Voici un exemple de construction d’un terme de De Bruijn (à droite) à partir d’un arbre d’analyse (à gauche) du mot (aa#->ab#->ba#->bb#->(ab#((bb#aa#)ab#))bb#->(bb#aa#->(bb#->bb#aa#))) :
Définition : Le codage binaire des termes de De Bruijn est l’application {t\in\mathcal T\mapsto\widehat t\in\{0,1\}^\ast} définie par induction structurelle avec les règles d’inférence suivantes sur l’ensemble des termes de De Bruijn :
— si le terme {t\in\mathcal T} est de la forme Vdb u, avec {u\in\mathbb N^\ast}, alors {\widehat t} est la chaîne de caractères 11..10 (avec le symbole 1 répété {u} fois).
— si le terme {t\in\mathcal T} est de la forme Adb (t1,t2), {t_1} et {t_2} étant deux termes de De Bruijn, alors {\widehat t} est la chaîne de caractères {01\widehat t_1\widehat t_2}.
— si le terme {t\in\mathcal T} est de la forme Fdb t1, où {t_1} est un terme de De Bruijn, alors {\widehat t} est la chaîne de caractères {00\widehat t_1}.
Nous utilisons le type string avec les caractères ’0’ et ’1’ afin de représenter des codages binaires de termes de De Bruijn.
Il est possible de s’appuyer sur la fonction charlist_of_string précédemment présentée.
4.3 Interpréteur et décompresseur de De Bruijn
Dans cette sous-section, nous construisons un interpréteur, c’est-à-dire une procédure qui évalue les expressions appartenant au langage L(G) et en déduisons une nouvelle description du mot {y_0=\text{«1000000…»}} relative à un décompresseur approprié.
Naïvement, lorsque nous rencontrons un sous-mot de la forme {w=(v\text{->}w_bw_a)} avec {v\in L(G_0)} et {(w_a,w_b)\in(L(G))^2}, nous aimerions que {w} soit équivalent à un mot tiré de {w_b} dont les occurrences de la variable {v} ont été remplacées par {w_a}.
Autrement dit, lorsqu’un arbre d’analyse est de la forme A (F (v, b), a), nous voudrions construire un nouvel arbre à partir de {b\in\mathcal A} et dans lequel les apparitions de {v\in L(G_0)} sont devenues des sous-arbres {a\in\mathcal A}.
Définition : Soient {(a,b)\in\mathcal A^2} deux arbres d’analyse et {v\in L(G_0)} une variable. La substitution de la variable {v} par l’arbre {a} dans l’arbre {b} est l’application {[v\leftarrow a]:\mathcal A\to\mathcal A} définie par induction structurelle avec les règles d’inférence suivantes :
— Si l’arbre {b\in\mathcal A} est de la forme V v1, avec {v_1\in L(G_0)}, alors {[v\leftarrow a](b)=\left\{\begin{array}{ll}a&\text{si }v=v_1,\\[8pt]b&\text{si }v\ne v_1.\end{array}\right.} — Si l’arbre {b\in\mathcal A} est de la forme A (b1, b2), où {b_1\in\mathcal A} et {b_2\in\mathcal A} sont deux arbres d’analyse, alors {[v\leftarrow a](b)=\mathrm A(b'_1,b'_2)}où {b'_1=[v\leftarrow a](b_1)} et {b'_2=[v\leftarrow a](b_2)}.
— Si l’arbre {b\in\mathcal A} est de la forme F (v1, b1), avec {v_1\in L(G_0)} et {b_1\in\mathcal A}, alors {[v\leftarrow a](b)=\left\{\begin{array}{ll}b&\text{si }v=v_1,\\[8pt]\mathrm F(v_1,b'_1)&\text{si }v\ne v_1\text{ et }v_1\notin\mathrm{VL}(a),\\[8pt]\mathrm F(v'_1,b'_1)&\text{sinon},\end{array}\right.}avec, dans le deuxième cas, {b'_1=[v\leftarrow a](b_1)} et, dans le troisième, {b'_1=[v\leftarrow a]([v_1\leftarrow v'_1](b_1))}, où {v'_1\in L(G_0)} est une variable inédite qui n’appartient pas à {\mathrm{VL}(a)\cup\mathrm{VL}(b)\cup\{v,v_1\}}.
Nous supposons déjà programmée une fonction new_string : unit -> string inspirée de la section 3 qui permet, si besoin, d’engendrer une variable de {L(G_0)} jamais encore utilisée.
Définition : La réduction en un pas est l’application {\triangleright:\mathcal A\to\mathcal A} définie par induction structuelle avec les règles d’inférence suivantes :
— Si l’arbre {a\in\mathcal A} est de la forme V v, où {v\in L(G_0)}, alors la valeur {\triangleright(a)} n’est pas définie.
— Si l’arbre {a\in\mathcal A} est de la forme A (a1, a2), où {a_1\in\mathcal A} et {a_2\in\mathcal A} sont deux arbres d’analyse, alors {\triangleright(a)=\left\{\begin{array}{ll}\mathrm A(a_1,a'_2)&\text{si }a_1\text{ est de la forme V v},\\[8pt]a'&\text{si }a_1\text{ est de la forme F (v, a11)},\\[8pt]\mathrm A(a'_1,a_2)&\text{sinon},\end{array}\right.}avec, respectivement, {a'_2=\triangleright(a_2)}, {a'=[v\leftarrow a_2](a_{11})} et {a'_1=\triangleright(a_1)}.
— Si l’arbre {a\in\mathcal A} est de la forme F (v, a1), où {v\in L(G_0)} et {a_1\in\mathcal A}, alors {\triangleright(a)=\mathrm F(v,a'_1)\quad\text{où }a'_1=\triangleright(a_1).}
La valeur de retour est le dernier arbre d’analyse rencontré.
Nous admettons que, pour tout entier naturel non nul n, si π est le mot de L(G) {\pi=\text{(a\#->((a\#a\#)a\#)}\lceil n\rceil\text{)},} l’expression interpret (parse pi) produit une incarnation de l’entier {n^{(n^n)}}. Nous notons B le décompresseur défini par
|
1 2 |
let decompB (z : string) : string = "string_of_int (int_of_ada (interpret (ada_of_tdb (decode " ^ z ^ "))))" |
decompB z0 a pour valeur de retour la chaîne de caractères {y_0=\text{«1000000…»}} et en calculer la longueur.
En déduire que la complexité de Kolmogoroff de {y_0} par rapport au décompresseur {B} vérifie {K_B(y_0)\le70.}