Partie I – Algorithme Single Pass
Cette partie comporte des questions nécessitant un code en langage C .
On cherche à classer {n=5} documents textuels {\mathrm{doc}_i,\ i\in[\![1,n]\!]} dans lesquels les termes {T_1} , {T_2} et {T_3} apparaissent un certain nombre de fois, ces occurrences étant décrites dans le tableau suivant : {\begin{array}{c|ccccc}&\mathrm{doc}_1&\mathrm{doc}_2&\mathrm{doc}_3&\mathrm{doc}_4&\mathrm{doc}_5\\[8pt]T_1&1&2&0&1&1\\[8pt]T_2&3&1&1&3&0\\[8pt]T_3&3&0&0&1&1\end{array}} Chaque document {\mathrm{doc}_i} est donc représenté par un ensemble de {p=3} valeurs.
On notera {d_i,\ i\in[\![1,n]\!]} un vecteur de {\mathbb N^3} , de composantes {d_{ij}}, {j\in[\![1,p]\!]}, {d_{ij}} indiquant le nombre d’occurrences du terme {T_j} dans le document {\mathrm{doc}_i}.
On cherche à voir si des textes traitent des mêmes thématiques, en faisant l’hypothèse que des textes sont sémantiquement proches si des termes communs apparaissent.
On notera de plus ci les centres de classe et {A_i} les classes correspondantes. {\begin{array}{c|c|c|c|c}\text{Itération}&c_1&c_2&A_1&A_2\\[8pt]1&d_2&d_5&&\\[8pt]2&&&&\\[8pt]3&&&&\end{array}}
On souhaite maintenant traiter ce problème par une méthode dite “single pass” décrite dans l’ algorithme 1. Algorithme 1 – Algorithme Single Pass
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
Entrées : (d1 … dn) les vecteurs des documents, θ un seuil appartient à R. Sorties : (A1 … Aj) les classes de centres (c1 … cj) début c1 = d1 ; // Initialisation A1 = {d1} ; j = 1 ; pour i de 2 à n faire pour k de 1 à j faire Étape (i) Calculer δ(di, ck) ; si Étape (ii) δ(di, ck) > θ pour tout ck alors j = j + 1 ; // Création d’une nouvelle classe Aj = {di} ; cj = di ; sinon // Indice du centre de classe le plus proche de di au sens de δ Étape (iii) ℓ = arg min(δ(di, ck)) pour 1 <= k < i ; Aℓ = Aℓ ∪ {di} ; // Affectation de di à la classe ℓ cℓ = (1 / |Aℓ|) Σ(di pour di ∈ Aℓ) ; // Recalcul de cℓ |
On propose d’implémenter cet algorithme en langage C.
À cet effet, on définit un type structuré vecteur permettant d’encoder les centres de classe et les textes.
|
1 2 3 4 5 6 |
struct vecteur_s { double *v; // pointeur vers les coordonnées int taille; // taille du vecteur int num_classe; // classe du vecteur }; typedef struct vecteur_s vecteur; |
Puisque le nombre de centres de classe varie au cours de l’algorithme, on utilise une liste chaînée de vecteurs pour représenter l’ensemble des centres de classe.
|
1 2 3 4 5 |
struct noeud_s { vecteur *c; struct noeud_s *suivant; }; typedef struct noeud_s noeud; |
void ajoutVecteur(vecteur *vec, noeud **tete) permettant d’ajouter un vecteur vec en tête de la liste des centres de classe pointée par tete.
On prendra soin de vérifier que l’allocation mémoire s’est bien passée.
On suppose dans la suite disposer :
– de la variable vecteur *documents[nb_documents] qui contient l’ensemble des documents, où pour tout {i\in[\![0,\mathrm{nbdocuments}-1]\!]}, documents[i] est égal à {d_{i+1}}.
– d’une fonction void recalculCentre (vecteur *documents, noeud **tete, int l) qui effectue le recalcul du centre {c_\ell} et met à jour le nœud correspondant dans la liste chaînée des centres de classe.
double delta(vecteur *di,vecteur *c) qui calcule la distance entre le document di et le centre de classe c (étape (i)de l’ algorithme 1). On suppose que d i et c ont la même taille.bool distmax(double dists[],int j,double theta) qui réalise l’étape (ii)de l’ algorithme 1. Le tableau dists contient les distances de d i à tous les ck : pour tout {k\in[\![0,j-1]\!]} l’élément dists[k] du tableau dists contient la distance de d i à {c_{k+1}} .
La fonction renvoie true si {\delta(d_i,c_k)>\theta\ \forall c_k} et false sinon.
int distmin(double dists[],int j) qui réalise l’étape (iii) de l’ algorithme 1. Le tableau dists contient les distances de d i à tous les ck comme dans la question précédente.
La fonction renvoie l’entier l décrit dans l’algorithme.
noeud *algorithme1(vecteur *documents, int nb_documents, double theta) .
Évaluer la complexité de l’ algorithme 1.
Partie II – Langages réguliers
Soit {\Sigma=\{a,b,c\}} un alphabet. {\Sigma^\ast} est l’ensemble des mots de longueur finie sur l’alphabet {\Sigma}. Pour u ∈ {\Sigma^\ast}, {|u|\in\mathbb N} désigne la longueur du mot u. On note {u_i,\ i\in[\![1,|u|]\!]} la i-ème lettre de u. Pour {k\in[\![1,|u|]\!]}, on note {u_{[1,k]}} le préfixe de u de longueur k, c’est-à-dire le mot {u_1\cdots u_k}.
On définit sur {\Sigma^\ast} la relation symétrique R de la manière suivante : u R v s’il existe w, z ∈ {\Sigma^\ast} tels que {u=wabz} et {v=wbaz}. On note {R^\ast} la fermeture réflexive transitive de R : u {R^\ast} v si {u=v} ou s’il existe des mots {x_0\cdots x_n} tels que : (i). {x_0=u}, (ii). pour {i\in[\![0,n-1]\!],\ i\lt\min(|u|,|v|),\ x_i\,R\,x_{i+1}} , (iii). {x_n=v}.
Soit u ∈ {\Sigma^\ast}. La classe de u modulo {R^\ast} est l’ensemble des mots v vérifiant v {R^\ast} u. Tous les mots de cette classe ont la même longueur. Ainsi, par exemple, {abcabb, abcbab, abcbba, bacabb, bacbab, bacbba} est une classe modulo {R^\ast}.
On définit la relation {\preceq} sur {\Sigma} telle que {a\lt b\lt c} par : pour u,v ∈ {\Sigma^\ast}, {u\preceq v} si l’une des deux conditions suivantes est réalisée : (i). {u=v}[1,|u|], (ii). il existe {i>1} tel que {u_{[1,i-1]}=v_{[1,i-1]}} et {u_i\lt v_i}.
Soit U une classe modulo {R^\ast}. Le représentant de U est le plus petit élément de cette classe pour l’ordre {\preceq}. On note L l’ensemble des représentants des classes modulo {R^\ast}.
Partie III – Correspondance de Burge
La correspondance de Burge permet d’exprimer une bijection entre des graphes simples et des tableaux de Young semi-standards. Ces objets combinatoires ont de nombreuses applications, notamment dans l’étude de groupes symétriques et la géométrique algébrique.
En théorie des graphes, ils permettent également de trouver, s’ils existent, les graphes simples dont les sommets sont contraints à avoir des degrés donnés. Cette partie comporte des questions nécessitant un code OCaml.
Pour ces questions, les réponses ne feront pas appel aux fonctionnalités impératives du langage (références, champs mutables, exceptions).
Notations
Dans toute la suite on notera :
– {[l]=[\![1,l]\!]} l’ensemble des entiers naturels de 1 à l, – {|E|} le cardinal de l’ensemble E ,
– {G=([l],A)} un graphe simple, c’est-à-dire un graphe non orienté à l sommets et m arêtes, sans boucles ni arêtes multiples,
– {d_i=|\{j\in[l],(i,j)\in A\}|} le degré du sommet {i\in[l]} dans le graphe {G=([l],A)}. De plus, les sommets de G seront ordonnés par degrés décroissants, de sorte que {d_1\ge d_2\ge\cdots\ge d_l\ge0}.
Définition 1 (Suite de degrés d’un graphe)
Soit {G=([l],A)} un graphe simple. Si di,{i\in[l]} est le degré du sommet i, avec {d_1\ge d_2\cdots\ge d_l\ge0}, la suite de degrés de G est le l-uplet {(d_1,d_2\cdots d_l)}.
III.1 – Partitions d’un entier
Définition 2 (Partition)
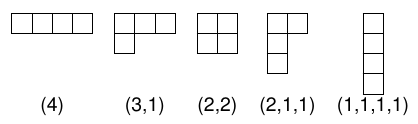
Une partitiond’un entier {n\in\mathbb N^\ast}, notée {\lambda\vdash n}, est une suite décroissante {\lambda=(\lambda_1,\lambda_2,\ldots,\lambda_l)} de nombres entiers strictement positifs de somme n. Par exemple, n = 4 a cinq partitions : (4), (3,1), (2,2), (2,1,1) et (1,1,1,1).
Une partition {\lambda=(\lambda_1\cdots\lambda_l)} ⊢ n peut être vue comme une suite de degrés sous certaines conditions.
Dans la suite, on considérera que la somme des termes de la suite d’entiers {(\lambda_1,\lambda_2\cdots\lambda_l)} est paire. Même avec cette contrainte, cette suite peut ne pas pouvoir générer de graphe simple.
Définition 3 (Suite graphique)
Une suite d’entiers {d_1\ge d_2\cdots\ge d_l\ge0} est dite graphique s’il existe un graphe simple dont la suite des degrés est {(d_1,d_2\cdots d_l)}. Notons qu’une suite graphique vérifie par définition {d_1\ge d_2\cdots\ge d_l}.
Pour déterminer si une suite d’entiers donnée est graphique, on peut utiliser l’algorithme d’Havel- Hakimi, basé sur le théorème suivant :
Théorème 1 (Havel-Hakimi)
(i). Pour tout {(d_1,\ldots,d_l)\in\mathbb N^l}, si {(d_1,\ldots,d_l)} est graphique, alors {d_{d_1+1}>0} et toute permutation décroissante de {(d_2-1,d_3-1,\ldots,d_{d_1+1}-1,d_{d_1+2},\ldots,d_l)} est graphique. (ii). Réciproquement, pour tout {(d_2,\ldots,d_l)\in\mathbb N^{l-1}} , si {(d_2,\ldots,d_l)} est graphique, alors pour {d_1\in[\![d_2+1,l-1]\!]}, la suite {(d_1,d_2+1,\ldots,d_{d_1+1}+1,d_{d_1+2},\ldots,d_l)} est graphique.
Pour cela, on pourra raisonner par l’absurde et supposer que le sommet 1 est adjacent à un maximum de sommets dans {(2\cdots d_1+1)}, mais pas à tous.
compare_entiers : int -> int -> int qui compare deux entiers et telle que l’appel à compare_entiers m n renvoie 1 si {m\lt n}, -1 si {m>n} et 0 sinon.decr_n : n -> int list -> int list option telle que pour tout {n\ge0} l’appel decr_n n l retourne Some l’, avec l’ la liste l dont les n premiers éléments sont décrémentés, s’ils étaient tous supérieurs à 1 et None sinon.havel_hakimi : int list -> bool qui retourne true si la liste passée en entrée, triée par ordre décroissant, est graphique et false sinon.
À chaque étape utilisant le théorème 1, il sera nécessaire de réordonner par ordre décroissant la liste list construite, ce qui pourra être fait à l’aide de l’appel à List.sort compare_entiers list.
Ainsi, il n’existe pas de correspondance univoque entre suite de degrés et graphe simple.
III.2 - Diagramme et tableau de Young
Définition 4 (Diagramme de Young d’une partition)
Le diagramme de Young de forme {\lambda}, noté Y ({\lambda}), d’une partition {\lambda=(\lambda_1,\lambda_2,\ldots,\lambda_l)} ⊢ n est un tableau de cases constitué de llignes alignées à gauche, chaque ligne {i\in[l]} ayant {\lambda_i} cases. Par convention, la ligne associée à {\lambda_1} est la première ligne du tableau.
Par exemple, les diagrammes de Young des partitions de l’entier 4 sont
Définition 5 (Diagonale d’un diagramme de Young)
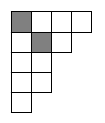
Soit Y ({\lambda}) un diagramme de Young. La diagonale de Y ({\lambda}) est définie par les r cases (i,i),{i\in[r]}. Dans le tableau suivant, {r=2} et les cases de la diagonale sont grisées.
Définition 6 (Partition conjuguée)
Soit Y ({\lambda}) un diagramme de Young associé à {\lambda\vdash n}. La partition conjuguée de {\lambda}, notée {\lambda^\ast=(\lambda_1^\ast,\ldots,\lambda_k^\ast)}, est la partition obtenue en énumérant le nombre de cases de Y ({\lambda}) par colonne, en partant de la colonne de gauche. On remarque immédiatement que pour tout j,{\lambda_j^\ast=|\{i,\lambda_i\ge j\}|}.
Définition 7 (Représentation de Frobenius d’un diagramme de Young)
Soient {(\lambda_1,\lambda_2,\ldots,\lambda_l)} ⊢ n une partition, Y ({\lambda}) son diagramme de Young et r la taille de sa diagonale. Pour {i\in[r]}, soient {\alpha_i=\lambda_i-i} le nombre de cases à droite de la case (i,i)dans la i-ème ligne de Y ({\lambda})et {\beta_i=\lambda_i^\ast-i} le nombre de cases en-dessous de la case (i,i) dans la i-ème colonne de Y ({\lambda}).
Alors {\alpha_1>\alpha_2\ge\cdots\alpha_r\ge0}, {\beta_1>\beta_2\ge\cdots\beta_r\ge0} et la notation de Frobenius de {\lambda} est donnée par {\lambda=\begin{pmatrix}\alpha_1&\alpha_2&\cdots&\alpha_r\\[8pt]\beta_1&\beta_2&\cdots&\beta_r\end{pmatrix}} .
Définition 8 (Tableau de Young)
Soit {\lambda\vdash n} une partition de {n>0}. Un {\lambda}-tableau de Young est un tableau obtenu en remplissant les cases d’un diagramme Y( {\lambda}) par des entiers dans [n].
Par exemple, pour {\lambda} = (2,1) {\vdash3}, les tableaux suivants sont des {\lambda}-tableaux
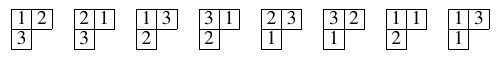
Dans la suite, on notera T (i,j)l’entier en position (i,j)dans le tableau T .
Définition 9 (Tableau de Young (semi)standard)
Un tableau de Young est dit semi standard si les éléments de chaque ligne (respectivement colonne) forment une suite croissante de gauche à droite (respectivement strictement croissante de haut en bas).
Il est dit standard s’il est semi-standard et si les entiers de 1 à n n’apparaissent qu’une et une seule fois. Dans les exemples précédents, les premier, troisième et septième tableaux sont semi standards. Les premier et troisième tableaux sont standards.
III.3 - Insertion de Schensted
Pour construire un tableau de Young semi-standard à partir d’une suite d’entiers d1 ,···dl, on utilise une méthode d’insertion proposée par Schensted.
On cherche à insérer dans un tableau de Young semi standard T un entier k, de sorte à ce que le tableau créé (contenant une case de plus) soit toujours un tableau de Young semi standard. On note cette opération d’insertion T ← k.
L’entier k est inséré dans T en le comparant aux valeurs de la première ligne et en déplaçant le premier entier plus grand que k en lisant la ligne de gauche à droite. S’il n’y a pas de plus grand élément, k est ajouté à la fin de la ligne.
Si un élément est déplacé, il est inséré dans la deuxième ligne et les lignes suivantes du tableau sont traitées de la même manière. L’algorithme 2 décrit l’insertion de k dans la i-ème ligne de T . Soit {T_0} le tableau de Young semi standard
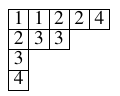
Même question pour l’insertion de la valeur 1 dans {T_0} .
Pour coder les tableaux de Young, on choisit d’utiliser un type OCaml type tableau = int list list et on encode la structure par liste de lignes. Algorithme 2 – Algorithme d’insertion d’un entier k dans la ligne i d’un tableau de Young semi standard
|
1 2 3 4 5 6 7 8 9 10 11 |
Insertion(T, k, i) Entrées : un tableau de Young semi standard T, un entier k à insérer, i la ligne traitée Sorties : un tableau de Young semi standard contenant k début si (la ligne i est vide) OU (k plus grand que l’élément le plus à droite de la ligne i) alors Ajouter k en bout de la ligne i de T sinon Soit j le plus petit indice tel que k < T(i, j) p = T(i, j) T(i, j) = k Insertion(T, p, i + 1) |
insereligne :int -> int list -> int*int list qui, à partir d’un entier k et d’une ligne i d’un tableau de Young semi standard, retourne un couple (m,r) où
- m = 0 et r est la ligne ioù k a été ajouté en queue, si k est plus grand que tous les éléments de la ligne i,
- m, qui est dans la ligne iet r est la ligne ioù m a été remplacé par k sinon.
insertion : int -> tableau -> tableau réalisant l’ algorithme 2.construit_tableau :int list -> tableau qui construit un tableau semi standard à partir d’une suite d’entiers.L’ algorithme 2 permet de définir une position (s,t), coordonnées de la case où k a été ajouté à T .
III.4 - Correspondance de Burge
Définition 10 (Tableau de Burge)
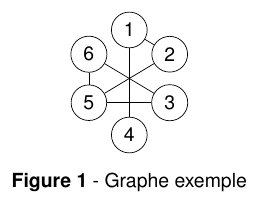
Soit {G=([l],A)} un graphe simple, {|A|=m}. Le tableau de Burge associé à G est défini par {B_G=\begin{pmatrix}u_1&u_2&\cdots&u_m\\[8pt]v_1&v_2&\cdots&v_m\end{pmatrix}} où pour tout {i\in[m]}{(u_i,v_i)} est une arête de G , avec {u_i>v_i}, le tableau étant formé de sorte que pour {i\in[m-1]}, {u_i\le u_{i+1}} et si {u_i=u_{i+1}} alors {v_i>v_{i+1}}. Soit le graphe G de la figure 1.
On utilise alors {B_G} pour associer à G un diagramme de Young Y ({\lambda}) représenté par une forme de Frobenius particulière, notée {F_Y=\begin{pmatrix}\alpha_1&\alpha_2&\cdots&\alpha_r\\[8pt]\alpha_1+1&\alpha_2+1&\cdots&\alpha_r+1\end{pmatrix}} , où r est le nombre de cases de la diagonale principale du diagramme de Young Y ({\lambda}) associé.
Ainsi, Y ({\lambda}) est divisé en deux parties symétriques. La partie inférieure est constituée de toutes les cases qui se trouvent strictement sous la diagonale et la partie supérieure est constituée du reste.
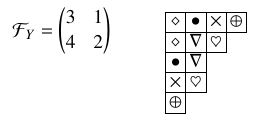
Chaque position dans la partie supérieure (inférieure) du diagramme de Young correspond à une position unique, appelée position opposée, dans la partie inférieure (supérieure) de Y ({\lambda}).
Par exemple, dans le diagramme de Young suivant, ayant comme représentation de Frobenius {F_Y} , les positions opposées sont codées par le même symbole.
L’ algorithme 3 utilise alors la représentation {B_G} d’un graphe G pour construire un tableau de Young semi standard dont le diagramme correspondant Y ({\lambda}) admet une représentation de Frobenius du type {F_Y} .
Dans cet algorithme, {T\leftarrow v_i} insère la valeur vi dans le tableau de Young semi standard T . Algorithme 3 – Algorithme de Burge
|
1 2 3 4 5 6 7 |
Entrées : BG de taille m × 2 Sorties : tableau de Young semi standard T dont la représentation de Frobenius du diagramme correspondant est du type FY début T = tableau vide ; // Initialisation pour i de 1 à m faire (s, t) = T ← vi Placer ui dans la position opposée à (s, t) |
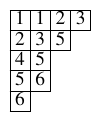
Cet algorithme produit, à partir du graphe de la figure 1, le tableau :
Notons pour terminer qu’il est à l’inverse possible de produire un tableau bidimensionnel {B_G} (et donc un graphe G ) à partir d’un tableau de Young semi standard Y ({\lambda}) de type {F_Y} .