PROBLÈME 1
Multiplication de grands entiers
Pour manipuler des entiers, les ordinateurs manipulent à la place des suites de bits encodant ces entiers. On admet que si n est un entier naturel et b est un entier supérieur ou égal à 2, il existe une décomposition de n sous la forme : {n=\sum_{i=0}^k n_i b^i} appelée décomposition de n en base b.
Les ni sont appelés chiffres de n en base b et chaque ni est dans {\{0,\ldots,b-1\}}. La base choisie de manière standard pour les entiers est habituellement {b=2} et pour cette valeur de b, on appelle les chiffres des bits.
Par ailleurs, pour des raisons liées au matériel, on se limite à un nombre de chiffres borné, entre 32 et 64 sur les machines modernes. Dans tout ce problème, on considère que la base est {b=2} et le seul langage utilisé est Python.
Dans ce problème, on va manipuler des listes de taille non bornée de chiffres. Ces listes seront représentées par des listes Python dans lesquelles le terme de rang i vaudra le ième bit, ni, c’est-à-dire que les bits associés à une puissance de 2 faibles seront en début de liste.
Par exemple [0,1, 0, 1, 0, 1] représente l’entier 42 = 0 + 2 + 0 + 8 + 0 + 32.
Cette fonction devra avoir une complexité linéaire en la taille de la liste qu’il n’est pas nécessaire de justifier.
Cette fonction prendra en argument deux listes de bits et renverra une nouvelle liste de bits correspondant à la somme des deux entiers encodés par les arguments. Il est interdit de convertir ces listes de bits en entiers, de faire la somme avec + et de reconvertir vers une liste de bits.
On pourra supposer que les deux listes sont de même longueur.
Pour simplifier les opérations mettant en œuvre deux listes de bits (addition, soustraction, multiplication, etc.), on souhaite que ces deux listes soient de même taille.
Votre programme vérifiera que l’entier size est supérieur à la taille de la liste des bits passée en argument et si cette assertion n’est pas vérifiée, interrompra l’exécution du programme.
Votre fonction ne modifiera pas la liste passée en argument, mais en renverra une nouvelle.
On pourra s’appuyer sur la valeur de n modulo b dans l’expression de sa décomposition et regarder l’effet d’une division entière de n par b avec cette expression.
On souhaite à présent réaliser la multiplication de deux entiers u et v encodés par des listes de bits. On peut supposer, sans perte de généralité, que la taille k de ces listes est la même et est divisible par 2, quitte à utiliser la fonction complement pour que ce soit le cas.
On peut s’appuyer sur la relation suivante en notant : {u=\sum_{i=0}^{k/2-1}u_i b^i+\sum_{i=k/2}^k u_i b^i=d_u+b^{k/2}f_u}et : {v=\sum_{i=0}^{k/2-1}v_i b^i+\sum_{i=k/2}^k v_i b^i=d_v+b^{k/2}f_v}on a alors : {\begin{array}{rcl}u\times v&=&\left(\sum_{i=0}^k u_i b^i\right)\times\left(\sum_{i=0}^k v_i b^i\right)\\[8pt]&=&\left(\sum_{i=0}^{k/2-1}u_i b^i+\sum_{i=k/2}^k u_i b^i\right)\\[8pt]&&{}\times\left(\sum_{i=0}^{k/2-1}v_i b^i+\sum_{i=k/2}^k v_i b^i\right)\\[8pt]&=&(d_u+b^{k/2}f_u)\times(d_v+b^{k/2}f_v)\\[8pt]&=&d_u\times d_v+b^{k/2}(f_u\times d_v+f_v\times d_u)\\[8pt]&&{}+b^k(f_u\times f_v).\end{array}}Ce calcul assure la véracité de l’égalité : {\begin{array}{rcl}u\times v&=&d_u\times d_v+b^{k/2}(f_u\times d_v+f_v\times d_u)\\[8pt]&&{}+b^k(f_u\times f_v).\end{array}\tag{1}} On peut donc calculer le produit {u\times v} en : a) décomposant les listes de bits de u et v en {(d_u,f_u)} et {(d_v,f_v)} respectivement, b) calculant récursivement les 4 produits {d_u\times d_v}, {f_u\times d_v}, {f_v\times d_u} et {f_u\times f_v}, c) faisant les multiplications par les puissances de b : {b^{k/2}(f_u\times d_v+f_v\times d_u)} et {b^k(f_u\times f_v)}, d) additionnant les trois termes obtenus pour respecter l’égalité ( 1).
On note C (k) la complexité de l’algorithme induit par cette méthode sur une liste de taille k. On admet que les opérations a, c et d peuvent se faire linéairement en k.
On pourra supposer que la taille de la liste est une puissance de 2 pour ne pas se préoccuper des arrondis lors de sa division par 2 et que la fonction C est croissante.
Le mathématicien soviétique Anatoly Karatsuba a proposé la relation suivante pour améliorer la complexité du calcul de la multiplication : {\begin{array}{rcl}u\times v&=&d_u\times d_v\\[8pt]&&{}+b^{k/2}\bigl(f_u\times f_v+d_u\times d_v\\[8pt]&&\phantom{{}+b^{k/2}\bigl(}{}-(f_u-d_u)\times(f_v-d_v)\bigr)\\[8pt]&&{}+b^k\times f_u\times f_v.\end{array}\tag{2}} On admet que cette relation est correcte.
Donner en conséquence l’équation vérifiée par la complexité de cette méthode de multiplication.
On admet qu’en résolvant cette équation vérifiée par la complexité, on obtient une complexité temporelle en {O(k^{\log_2(3)})\simeq O(k^{1,586})}, ce qui est mieux que l’approche précédente.
Cette fonction renverra une nouvelle liste sans modifier celle passée en argument. On considère le code Python d’une fonction karatsuba(lst1, lst2) pour réaliser la méthode proposée par Karatsuba.
On suppose disposer d’une fonction de somme sum_bit_lst(lst1, lst2) et de soustraction sub_bit_lst(lst1, lst2) qui réalisent les opérations attendues en temps linéaire en la taille de leurs entrées.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
def karatsuba(lst1, lst2): n = max(len(lst1), len(lst2)) lst1 = complement(lst1, n) lst2 = complement(lst2, n) if n == 0: # A : compléter ici if n == 1: # B : compléter ici else: h = n // 2 d1 = lst1[0:h] f1 = lst1[h:] d2 = lst2[0:h] f2 = lst2[h:] # C : compléter ici |
Plusieurs lignes peuvent être nécessaires pour compléter certaines parties.
PROBLÈME 2
Ensembles de mots implémentés par tries
On s’intéresse dans ce problème à l’implémentation de structures permettant de représenter des ensembles de mots.
Ce type de structure peut être utilisé pour la correction orthographique — si un mot n’est pas dans l’ensemble des mots connus, il y a probablement une faute — ou bien l’auto-complétion : s’il existe un mot dans notre ensemble qui commence comme celui qui vient d’être tapé, on le propose pour compléter.
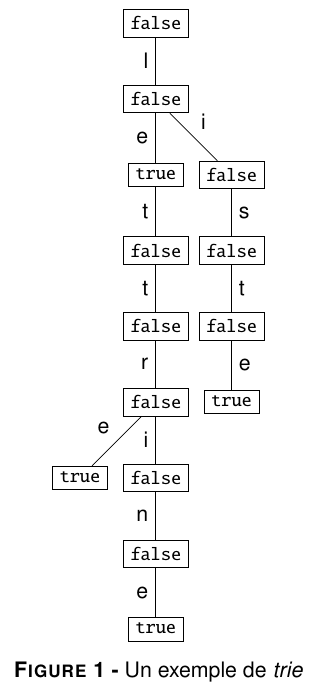
Dans la suite, on propose une première manière d’implémenter un ensemble de mots nommée trie. Il s’agit d’une structure d’arbre dans laquelle chaque nœud contient un booléen et a un enfant (éventuellement vide) par lettre de l’alphabet.
Pour alléger les représentations, on n’affichera pas les enfants vides. Un chemin de la racine vers un nœud de l’arbre correspond donc à une suite de lettres, c’est-à-dire un mot. On dit qu’un mot appartient au trie si le dernier nœud du chemin étiqueté par ce mot depuis la racine contient true.
Par exemple, l’ensemble de mots {le, lettre, lettrine, liste} est représenté par le trie en figure 1. Le mot « let » n’est pas dans ce trie car le nœud sur lequel on arrive en lisant ce mot depuis la racine n’est pas étiquetté par true.
Dans la suite du problème, le langage OCaml sera le seul langage utilisé. Pour manipuler des mots en OCaml, on choisit d’utiliser des listes de lettres ; une lettre étant représentée par un char.
On commence par se doter d’une fonction permettant de convertir un objet de type string en une liste de caractères. Il est rappelé qu’on peut accéder au caractère d’indice i d’une chaîne s en OCaml avec la syntaxe s.[i] et qu’on peut connaître la longueur de s via la fonction String.length.
string_to_list : string -> char list qui s’évalue en la liste des caractères de la chaîne passée en argument. Par exemple, string_to_list « lettre » s’évaluera en [’l’; ’e’; ’t’;’t’;’r’;’e’] .
On pourra s’appuyer sur une fonction auxiliaire si besoin, mais dans ce cas on prendra soin d’expliquer le rôle de cette fonction.
La fonction aura une complexité linéaire en la taille de la chaîne qu’on justifiera.
On considère le type récursif OCaml suivant pour implémenter un trie.
|
1 |
type trie = Node of bool * (char * trie) list |
On omet les arbres vides, un nœud peut donc avoir un nombre variable d’enfants.
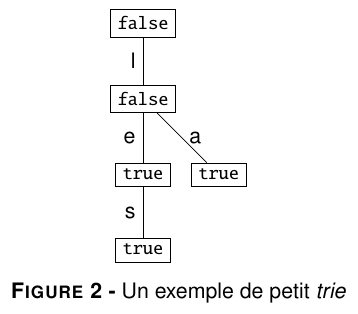
Les enfants d’un nœud sont stockés dans une liste de couples (lettre, arbre) et chaque nœud, y compris les feuilles, contient un booléen indiquant l’éventuelle présence d’un mot. Par exemple, le trie en figure 2 est représenté en OCaml par l’objet de type trie suivant :
|
1 2 3 4 |
Node (false, [('l', Node (false, [('e', Node (true, [('s', Node (true, []))])); ('a', Node (true, []))]))]) |
empty_trie : unit -> trie qui renvoie le trie vide ayant le moins de nœuds possible.max_list : int list -> int qui renvoie le plus grand élément d’une liste supposée non vide.list_map : ('a -> 'b) -> 'a list -> 'b list qui prend en argument une fonction f et une liste lst et renvoie la liste des images par f des éléments de lst, dans le même ordre.
Il est interdit d’utiliser la fonction List.map dans cette question.
height : trie -> int qui calcule la hauteur d’un trie (la définition de la hauteur d’un trie est la même que pour un arbre quelconque).
On pourra s’appuyer sur les deux fonctions précédentes.
size : trie -> int qui calcule le nombre de nœuds dans un trie (attention, il ne s’agit pas du nombre de mots dans le trie, tous les nœuds comptent ici).Considérons la fonction suivante sur les trie :
|
1 2 3 4 5 6 |
let rec f t = match t with | Node (true, []) -> 1 | Node (false, []) -> 0 | Node (b, (letter, child) :: tail) -> (f child) + (f (Node (b, tail))) |
is_in_trie : char list -> trie -> bool qui prend en entrée un mot sous forme d’une liste de ses caractères et un trie et s’évalue en true si le mot est présent dans la structure et false sinon.add_to_trie : char list -> trie -> trie qui prend un mot sous forme d’une liste de ses caractères et un trie et qui s’évalue en un trie contenant les mots contenus dans le trie passé en argument et le mot passé en argument.On souhaite maintenant interpréter un trie comme un cas particulier d’automate de manière à ce que les mots reconnus par cet automate soient ceux présents dans le trie.
Pour tenter de résoudre le problème évoqué en Q24, on se propose de modifier l’automate obtenu à partir d’un trie pour y supprimer les états redondants.
On peut noter que cet automate est déterministe et donc que la lecture d’une lettre c depuis un état q amène à au plus un état, noté {\delta(q,c)} s’il existe. Si la lecture de c depuis q n’est pas possible, on parle de blocage.
Soient deux états q et {q'} de l’automate, {\Sigma} son alphabet et δ sa fonction de transition. On considère une relation binaire E sur les états. Deux états q et {q'} sont en relation selon E , ce que l’on note {q\,E\,q'}, si :
– (q et {q'} sont tous deux finaux) ou ( q et {q'} sont tous deux non finaux),
– {\forall c\in\Sigma}, soit c est un blocage pour q et {q'}, soit {\delta(q,c)\,E\,\delta(q',c)}.
Même chose pour un couple d’états avec transition sortante.
On admet que pour deux états qui sont en relation selon E , on reconnaît le même langage en commençant une lecture depuis l’un ou l’autre de ces états.
En donner les grandes lignes en expliquant la démarche et illustrer cette démarche sur le trie contenant les mots {car, par, cal, pal}.
PROBLÈME 3
Logique implicationnelle
Un système logique est défini par :
– une syntaxe S, qui décrit la façon dont il faut écrire les formules du système,
– une sémantique M , qui explique le sens à leur donner,
– un système de déduction D, qui établit les règles syntaxiques permettant de faire des preuves. On introduit tout d’abord un premier système logique, le calcul propositionnel {CP=(S_P,M_P,D_P)} :
– {S_P} est l’ensemble des formules définies inductivement à partir de {\top}, {\bot} et des variables propositionnelles à l’aide des connecteurs classiques {\land}, {\lor}, {\neg} et {\to},
– {M_P} est la sémantique standard construite à partir des tables de vérité pour {\land}, {\lor}, {\neg} et {\to},
– {D_P} est la déduction naturelle, dont les règles sont rappelées en annexe 1.
On dit qu’un système {\Sigma} de connecteurs est complet si et seulement si toute formule de {S_P} est équivalente à une formule de {S_P} qui ne fait intervenir que les connecteurs de {\Sigma}. Par exemple, {\{\neg,\lor,\land,\to\}} est un système complet de connecteurs.
On introduit dans la suite du problème un nouveau système logique, le calcul purement implicationnel {CI=(S_I,M_I,D_I)} :
– Les formules de {S_I} sont définies par induction de la façon suivante :
– les symboles {\bot}, {\top} et les variables propositionnelles sont des formules de {S_I},
– si A et B sont des formules de {S_I}, alors {A\to B} également. Autrement dit, on restreint les formules de {S_P} à celles qui font intervenir uniquement le connecteur {\to}, d’où le nom du système.
– La sémantique M I est la sémantique standard.
– Le système de déduction {D_I} est donné par les règles de déduction suivantes : {\dfrac{}{\Gamma,A\vdash A}\;(\mathrm{ax})} {\dfrac{}{\Gamma\vdash((A\to B)\to A)\to A}\;(\mathrm{Peirce})} {\dfrac{\Gamma\vdash A\to B\quad\Gamma\vdash A}{\Gamma\vdash B}\;(\mathrm{elim}\text{-}\to)} {\dfrac{\Gamma,A\vdash B}{\Gamma\vdash A\to B}\;(\mathrm{intro}\text{-}\to)} Autrement dit, on restreint les règles de la déduction naturelle à l’axiome, l’introduction et l’élimination du {\to} et on y ajoute un axiome, appelé la loi de Peirce.
1. {A\vdash(A\to B)\to B}
2. {A\to B,B\to C\vdash A\to C}
3. {(A\to B)\to C,A\to C\vdash C} . On pourra utiliser l’instance suivante de la loi de Peirce : {((C\to B)\to C)\to C} .
Justifier brièvement la réponse.
On rappelle que si : {\dfrac{\Gamma\vdash F_1\quad\cdots\quad\Gamma\vdash F_k}{\Gamma\vdash F}} est une règle, les séquents {\Gamma\vdash F_1,\ldots,\Gamma\vdash F_k} au-dessus de la barre se nomment les prémisses de la règle et le séquent {\Gamma\vdash F} en est sa conclusion.
On dit qu’une règle est dérivable dans un système de déduction si on peut construire sa conclusion avec les règles du système de déduction en supposant qu’on a déjà une preuve de ses prémisses.
Par exemple, la règle suivante est dérivable dans {D_I} : {\dfrac{\Gamma,A\vdash B\quad\Gamma\vdash A}{\Gamma\vdash B}\;(\mathrm{cut})} En effet, on peut la prouver en n’utilisant que les règles de {D_I} via cet arbre : {\dfrac{\dfrac{\Gamma,A\vdash B\;(\text{supposé})}{\Gamma\vdash A\to B}\;(\mathrm{intro}\text{-}\to)\;\Gamma\vdash A\;(\text{supposé})}{\Gamma\vdash B}\;(\mathrm{elim}\text{-}\to)}
On pourra utiliser l’instance suivante de la loi de Peirce : {((A\to\bot)\to A)\to A}.
Annexe 1
Règles de la déduction naturelle
– Axiome : {\dfrac{}{\Gamma,A\vdash A}\;(\mathrm{ax})}– Affaiblissement : {\dfrac{\Gamma\vdash A}{\Gamma,B\vdash A}\;(\mathrm{aff})}– Introduction et élimination de l’implication : {\dfrac{\Gamma,A\vdash B}{\Gamma\vdash A\to B}\;(\mathrm{intro}\text{-}\to)} {\dfrac{\Gamma\vdash A\to B\quad\Gamma\vdash A}{\Gamma\vdash B}\;(\mathrm{elim}\text{-}\to)}– Introduction et éliminations du et : {\dfrac{\Gamma\vdash A\quad\Gamma\vdash B}{\Gamma\vdash A\land B}\;(\mathrm{intro}\text{-}\land)} {\dfrac{\Gamma\vdash A\land B}{\Gamma\vdash A}\;(\mathrm{elim}\text{-}\land)} {\dfrac{\Gamma\vdash A\land B}{\Gamma\vdash B}\;(\mathrm{elim}\text{-}\land)}– Introductions et élimination du ou : {\dfrac{\Gamma\vdash A}{\Gamma\vdash A\lor B}\;(\mathrm{intro}\text{-}\lor)} {\dfrac{\Gamma\vdash B}{\Gamma\vdash A\lor B}\;(\mathrm{intro}\text{-}\lor)} {\dfrac{\Gamma\vdash A\lor B\quad\Gamma,A\vdash C\quad\Gamma,B\vdash C}{\Gamma\vdash C}\;(\mathrm{elim}\text{-}\lor)}– Introdution et élimination du non : {\dfrac{\Gamma,A\vdash\bot}{\Gamma\vdash\neg A}\;(\mathrm{intro}\text{-}\neg)} {\dfrac{\Gamma\vdash A\quad\Gamma\vdash\neg A}{\Gamma\vdash\bot}\;(\mathrm{elim}\text{-}\neg)}– Élimination du {\bot} : {\dfrac{\Gamma\vdash\bot}{\Gamma\vdash A}\;(\mathrm{elim}\text{-}\bot)}– Raisonnement par l’absurde : {\dfrac{\Gamma,\neg A\vdash\bot}{\Gamma\vdash A}\;(\mathrm{ra})}