Partie I – Coloration de graphes
L’objectif de cette partie est de proposer une implémentation en Python d’une solution au problème de coloration d’un graphe.
I.1 – Définitions et propriétés
Soit {G=(S,A)} un graphe fini non orienté avec S son ensemble de sommets et A son ensemble d’arêtes. On suppose que le graphe est simple c’est-à-dire qu’il ne comporte pas de boucles et que chaque paire de sommets est reliée par au plus une arête. On note n, le cardinal de l’ensemble S .
Les sommets sont numérotés de 0 à {n-1}. Étant donné un entier naturel k, une k-coloration des sommets de G est une application {c:S\to\{0,1,\ldots,k-1\}} telle que pour chaque arête {x,y} d’extrémités x et y, {c(x)\ne c(y)}. Si {c(x)=i}, on considèrera que la couleur i est affectée au sommet x.
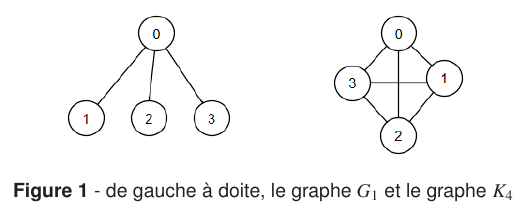
Si G admet une k-coloration, il est k-coloriable. On définit le nombre chromatique {\chi(G)} d’un graphe G fini par {\chi(G)=\min\{k\in\mathbb N,\ G\text{ est }k\text{-coloriable}\}}. Une clique est un sous-ensemble de sommets du graphe, adjacents 2 à 2. On dit qu’un graphe est complet si il est une clique. On notera {K_p} le graphe complet à p sommets.
On pose {\omega(G)=\max\{p\in\mathbb N\mid K_p\text{ est une clique de }G\}} , avec N l’ensemble des entiers naturels.
I.2 – Algorithmique et programmation en Python (Informatique Commune)
La coloration d’un graphe G avec {\chi(G)} couleurs est un problème complexe. Dans cette sous-partie, nous présentons une heuristique permettant de construire une coloration d’un graphe donné.
Dans la suite, on implémente un graphe par un dictionnaire (type dict en Python), contenant les listes d’adjacence des sommets. Les clés du dictionnaire sont les numéros des sommets et la valeur correspondant à la clé i du dictionnaire est la liste d’adjacence du sommet numéro i.
Notons qu’il serait ici possible d’implémenter le graphe par des listes d’adjacence dans un tableau, dans la mesure où les sommets sont numérotés de 0 à {n-1}.
degres_sommets(d) qui prend en paramètre un dictionnaire d représentant un graphe et renvoie une liste de couples {(d_i,i)}, i étant le numéro d’un sommet parcourant l’ensemble {0, …,{n-1}}et {d_i} le degré du sommet i.tri(l) qui trie une liste de couples l dans l’ordre décroissant par rapport à la première composante du couple.
En déduire une fonction tri_degres(d) qui prend en paramètre un dictionnaire d représentant un graphe et renvoie une liste contenant les numéros des sommets, triés par degrés décroissants.
test(d,c) qui prend en paramètre un dictionnaire d représentant un graphe G, un dictionnaire c dont les clés représentent les sommets du graphe G et les valeurs, leurs couleurs.
La fonction renvoie True si c est une 2-coloration pour G.
On considère ci-dessous, l’algorithme de coloriage de Welsh-Powel. Algorithme 1 : Welsh-Powel (coloration de graphe)
|
1 2 3 4 5 6 7 8 9 10 11 |
Entrée : un graphe G à n sommets Sortie : liste d’entiers contenant en position i la couleur du sommet numéro i Début Ordonner les sommets selon les degrés décroissants dans une liste li ; colorie : dictionnaire vide qui à terme, associera à chaque clé i, la couleur du sommet i ; Tant qu’il reste des sommets à colorier faire Chercher dans li le premier sommet non colorié et le colorier avec la plus petite couleur c non utilisée ; Colorier avec cette même couleur, en respectant leur ordre dans li, tous les sommets non coloriés et non adjacents à des sommets de couleur c ; Fin Retourner colorie Fin |
adjacent(d,dc,s,c) qui prend en paramètre un graphe représenté par un dictionnaire d, un dictionnaire dc contenant la couleur des sommets coloriés, le numéro d’un sommet s, une couleur c et renvoie True si le sommet s est adjacent à l’un des sommets de couleur c, False sinon.Application
Le tableau ci-dessous représente les liens d’amitiés entre huit étudiants : Alice (A), Béatrice (B), Carl (C), David (D), Eloïs (E), Fanny (F), Gary(G) et Hedge (H).
| Prénom | Ami·e avec |
|---|---|
| A | B, C, G |
| B | A, C, E, F |
| C | A, B |
| D | E, F |
| E | B, D, F |
| F | B, D, E, H |
| G | A, H |
| H | F, G |
On souhaite créer des groupes de travail.
Dans le contexte de l’application, un groupe contient au moins 2 étudiants tel que chaque étudiant soit dans un groupe différent de celui de ses amis.
Partie II – Satisfiabilité d’une formule propositionnelle
Le langage utilisé dans cette partie est OCaml. Une formule propositionnelle est construite à l’aide de constantes propositionnelles, de variables propositionnelles et de connecteurs logiques. Les connecteurs logiques seront notés {\neg} (négation), {\land} (conjonction), {\lor} (disjonction).
Dans cette partie, on étudie le problème de satisfiabilité d’une formule et son application à la détermination d’une conséquence logique entre 2 formules propositionnelles. Le problème CNF-SAT est défini de la façon suivante.
Étant donné une formule sous forme normale conjonctive, admet-elle un modèle, c’est-à-dire une valuation des variables, qui rende la formule vraie ? On souhaite écrire un programme qui teste si une valuation donnée rend une telle formule vraie.
Dans cette partie, on considère que si une formule contient n variables propositionnelles, elles seront désignées par {x_0,x_1,\ldots,x_{n-1}} . On définit le type OCaml suivant :
|
1 |
type clause = Var of int | Non of clause | Ou of clause * clause |
L’argument du constructeur Var correspond au numéro de la variable concernée.
Une formule sous forme normale conjonctive ayant m clauses sera implémentée par une liste de m clauses. Les tableaux seront implémentés par le module Array dont les éléments suivants pourront être utilisés :
– type 'a array, notations [| |]
– création d’un tableau : make : int -> 'a -> 'a array
– accès à l’élément d’indice i du tableau t : t.(i)
– modification de l’élément placé à l’indice i du tableau t : t.(i) <- v
- taille du tableau : length : 'a array -> int
evalue_clause : clause -> bool array -> bool qui prend en paramètre une clause et une valuation représentée par un tableau contenant à l’indice i, la valeur de vérité de la variable {x_i} et renvoie la valeur de vérité de la clause.evalue_FNC : clause list -> bool array -> bool qui prend en paramètre une clause et une valuation représentée par un tableau contenant à l’indice i, la valeur de vérité de la variable {x_i} et évalue une formule donnée sous forme normale conjonctive.[|false;true;true|] ? Justifier.Étant donné une valuation, on considérera que si la valeur true correspond à 1 et la valeur false correspond à 0, la valuation suivante correspond à l’ajout de 1 au nombre binaire associé. Ainsi, la valuation suivante de [|false;true;false|] est [|false;true;true|]. On considère que la valuation suivante de [|true;true;true|] n’existe pas.
Écrire une fonction de signature suivant : bool array -> bool qui prend en paramètre un tableau de booléens, lui attribue la valuation "suivante" si possible et renvoie true ; sinon renvoie false.
satisfiable : clause list -> int -> bool qui prend en paramètre une formule en forme normale conjonctive, son nombre de variables et renvoie true si il existe une valuation qui rend la formule vraie, false sinon.Conséquence logique entre 2 formules
Définition
Une formule {\varphi} est une conséquence logique d’un ensemble fini de n formules {\Gamma=\{F_1,\ldots,F_n\}}, n étant un entier naturel supérieur ou égal à 1, si tout modèle de {\varphi} est un modèle de {\Gamma}. On note {\Gamma\models\varphi}. On admettra que toute formule admet une formule équivalente sous forme normale conjonctive.
Justifier cette méthode, puis construire un arbre de preuve qui démontre le séquent {\Gamma:P\to Q,Q\to R,P\vdash P} où P,Q ,R désignent des variables propositionnelles représentant des formules logiques, à partir des règles d’inférence de la déduction naturelle ; les règles et notations utilisées seront clairement mentionnées.
Partie III - Automates et reconnaissance de motifs
Dans cette partie, le langage utilisé est OCaml . On s’intéresse à la reconnaissance de motifs dans un texte en utilisant une méthode naïve, puis des automates.
III.1 - Autour de l’algorithme naïf de recherche de caractères
Définitions
Un alphabet A est un ensemble fini non vide d’éléments appelés lettres. Un mot défini sur A est une suite finie d’éléments de A. Le mot vide sera noté {\varepsilon}. L’ensemble des mots sur l’alphabet A est noté {A^\ast}. La longueur d’un mot x, notée |x|est le nombre de lettres de ce mot.
Pour i allant de 0 à {|x|-1}, {x_i} désignera la lettre en position i. Ainsi, aab est un mot de longueur 3, sur tout alphabet contenant les lettres a et b. Un mot x est un facteur d’un mot y si il existe 2 mots u et v tels que {y=uxv}. Dans ce cas, on dit qu’il y a une occurrence de x dans y.
Quand u = {\varepsilon}, x est un préfixe de y et quand v = {\varepsilon}, x est un suffixe de y. Soit x un mot non vide. Un entier {0\lt p\le|x|} est une période de x si {x_i=x_{i+p}} pour {0\le i\le|x|-p-1}. On définit la période de x comme étant la plus petite des périodes.
Un bord d’un mot non vide x est un facteur de x, différent de x et qui est à la fois un préfixe et un suffixe de la chaîne de caractères. Par exemple, {\varepsilon}, a,aa,aabaa sont les bords du mot aabaabaa. On note {\operatorname{Bord}(x)} le plus long bord de x.
On constate que lorsqu’il est défini, le bord d’un bord d’un mot x est aussi un bord de x. On le note {\operatorname{Bord}^2(x)}. On définit ainsi récursivement {\operatorname{Bord}^n(x)} avec n un entier naturel. En OCaml, les fonctions suivantes pourront être utilisées sur le type string :
- String.length : longueur de la chaîne de caractères
- s.[i] : accès à la lettre d’indice ide la chaîne s
- ^ : opérateur concaténation
occurrence : string -> string -> bool qui prend en paramètre 2 chaînes de caractères x , y et renvoie true si il existe une occurrence de x dans y, false sinon.periode : string -> int qui renvoie la période d’une chaîne de caractères.Montrer par récurrence sur la longueur des mots que {\operatorname{Bord}(x),\operatorname{Bord}^2(x),\ldots,\operatorname{Bord}^n(x)} est la suite des bords de x dans l’ordre décroissant de leur longueur et que {|x|\!-\!|\operatorname{Bord}(x)|\!,\!|x|\!-\!\operatorname{Bord}^2(x)|\!,\!\ldots\!,\!|x|\!-\!|\operatorname{Bord}^n(x)|} est la suite des périodes de x dans l’ordre croissant.
III.2 - Localisation des occurrences d’un motif à l’aide d’un automate
Un automate déterministe M sur l’alphabet A est composé d’un ensemble d’états finis Q , d’un état initial {q_0} , d’un ensemble d’états terminaux {T\subseteq Q} et d’une fonction de transitions {\delta:Q\times A\to Q} . On le désigne par un quintuplet {(Q,A,q_0,T,\delta)}.
On dit qu’il est complet si δ est définie pour chaque élément de {Q\times A}. Certains automates peuvent être utilisés comme machine de recherche pour le traitement séquentiel de textes. Étant donné un alphabet A, un motif X représente un langage non vide ne contenant pas le mot vide.
Le problème de la recherche de motifs est celui de la localisation d’occurrences de mots du langage dans d’autres mots. On suppose qu’on dispose d’un automate déterministe M complet qui reconnaît le langage {A^\ast X} , autrement dit, l’automate M reconnaît les mots qui ont comme suffixe un mot de X .
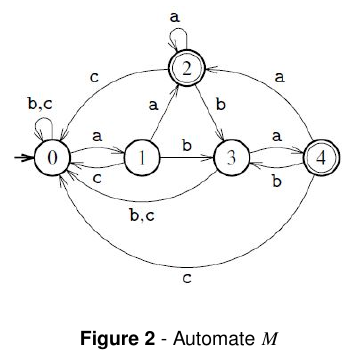
L’algorithme suivant permet de localiser les mots de X reconnus dans un texte t, considéré comme une chaîne de caractères. Dans la suite, l’automate M de la figure 2 ci-après sera cité en exemple.
Il est défini sur l’alphabet {A=\{a,b,c\}} Algorithme 2 : reconnaissance de mots dans un texte
|
1 2 3 4 5 6 7 8 9 10 11 12 |
Cherche(M, t) ; Début e ← initial[M] ; lst ← liste vide ; Pour chaque lettre λ de t prise dans l’ordre croissant de leurs indices faire e ← δ(e, λ) ; Si e est un état terminal alors ajouter à lst l’indice de λ dans t ; Fin Fin Retourner lst ; Fin |
On définit en OCaml un type automate par :
|
1 2 |
type auto = {etats: int list; alphabet: char list; initial: int; transition: int -> char -> int; final: int list};; |
Que contient la liste l de l’algorithme cherche avec l’automate ci-dessus et t= cabaac?
cherche : auto -> string -> int list qui implémente l’algorithme cherche.