Partie I – Palindromes
En langue française, « ressasser » est le mot palindrome le plus long, tandis qu’il semble que « saippuakauppias » soit le plus long mot palindrome au monde, désignant un marchand de savon en Finlande. L’objet de cette partie est de compter le nombre de palindromes présents dans un mot donné.
Soit {\Sigma} un alphabet fini contenant au moins deux lettres. On note {u=u_0\cdots u_{n-1}} un mot sur {\Sigma}, composé de n lettres {u_i\in\Sigma,\ i\in\llbracket0,n-1\rrbracket}. La longueur de u est notée {|u|}. Pour {0\le i\lt j\le n}, on note u[i, j] le mot {u_i\cdots u_{j-1}}. L’ensemble des mots construits sur {\Sigma} et contenant le mot vide {\varepsilon} est noté {\Sigma^*}.
Définition 1 (Miroir)
Soit {u\in\Sigma^*}. Le miroir de {u=u_0\cdots u_{n-1}}, noté {\overline u}, est le mot {\overline u=u_{n-1}\cdots u_0}. Par convention {\overline\varepsilon=\varepsilon}.
Définition 2 (Palindrome)
{u\in\Sigma^*} est un palindrome si et seulement si {u=\overline u}. Par convention, le mot vide {\varepsilon} n’est pas considéré comme un palindrome. On dira qu’un palindrome u est pair (respectivement impair ) lorsque sa longueur {|u|} est paire (resp. impaire).
On recherche donc dans cette partie le nombre de palindromes facteurs d’un mot {u\in\Sigma^*} (comptés avec les multiplicités éventuelles), soit le cardinal de l’ensemble {\{(i,j),\ 0\le i\lt j\le |u|,\ u[i,j]=\overline{u[i,j]}\}}. Dit autrement, on recherche le nombre de palindromes contenus dans u.
En parcourant naïvement les lettres d’un mot u donné, on peut proposer un algorithme en pseudo-code permettant de compter le nombre palindromes de u (algorithme 1). Algorithme 1 – Décompte naïf du nombre de palindromes contenus dans un mot donné.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
Entrées : Un mot u. Sorties : Le nombre de palindromes contenus dans u. début nb = 0 pour i = 0 à |u|-1 faire pour j = 0 à |u|-1 faire estPalindrome = True pour k = i à j-1 faire si u[i] ≠ u[j-k-1] alors estPalindrome = False Sortir du pour k si estPalindrome alors nb = nb+1 retourner nb |
On souhaite bien sûr améliorer cette première idée. Pour ce faire, on utilise tout d’abord le paradigme de la programmation dynamique. Pour {u\in\Sigma^*}, on définit un tableau de booléens P de taille {(|u|+1)\times(|u|+1)}, P[i][ j] étant vrai si u[i, j] est un palindrome. On a donc pour tout {i\in\llbracket0,|u|-1\rrbracket}, P[i][i + 1] = True.
Évaluer sa complexité.
On insère maintenant entre chaque paire de lettres de u, ainsi qu’au début et à la fin du mot, un symbole spécial noté #. On appelle ce nouveau mot {u^{\#}}. Ainsi, le mot u = abba se transforme en {u^{\#}} = #a#b#b#a#.
On voit que les palindromes impairs sont importants. On va donc construire un algorithme de recherche de ce type de palindrome.
Définition 3 (Rayon d’un palindrome)
Soient {u\in\Sigma^*} et {i\in\llbracket0,|u|-1\rrbracket}. On dit qu’il existe un palindrome centré en i de rayon {\rho>0} si : (i). {i-\rho\ge0}, (ii). {i+\rho+1\le|u|}, (iii). {u[i-\rho,i+\rho+1]} est un palindrome. Le rayon maximal {\widehat\rho_i} d’un palindrome centré en i est le plus grand rayon d’un palindrome centré en i.
Par exemple, si u = abbababab et i = 4, alors b est un palindrome centré en 4 de rayon 0, aba est un palindrome centré en 4 de rayon 1, babab est un palindrome centré en 4 de rayon 2 et c’est le plus grand, donc {\widehat\rho_4=2}.
Évaluer sa complexité.
En utilisant cette remarque, on développe un algorithme, dit de Manacher, qui construit un tableau d’entiers T permettant de compter le nombre de palindromes d’un mot u.
Plus précisément, pour chaque position {i\in\llbracket1,|u|-1\rrbracket}, T [i] indique le rayon maximal {\widehat\rho_i}, donc tel que la sous-chaîne de {i-\rho_i} à {i-\rho_i+1} est un palindrome.
L’algorithme 2 consiste à incrémenter T [i] jusqu’à trouver le plus grand palindrome {u[i-T[i],i+T[i+]+1]} centré en i. Algorithme 2 – Algorithme de Manacher
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
Entrées : Un mot u Sorties : Un tableau T. début Initialiser un tableau T de |u| cases, initialisées à 0 k = 0 pour i = 1 à |u|-1 faire j = i-k si T[k] >= j alors T[i] = min(T[k-j], T[k]-j) tant que (i-(T[i]+1)) >= 0 ET (i+T[i]+1) < |u| ET (u[i-(T[i]+1)] = u[i+T[i]+1]) faire T[i] = T[i]+1 k = i retourner T |
Partie II – Traversée de rivière
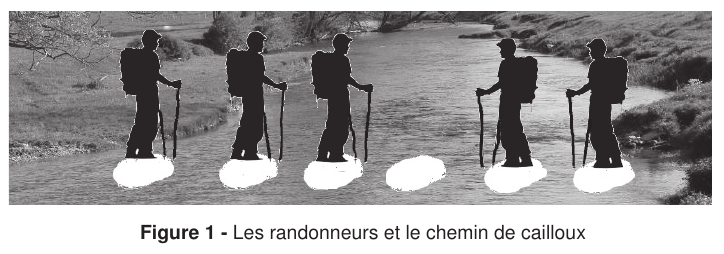
Cette partie comporte des questions nécessitant un code OCaml. Dans une vallée des Alpes, un passage à gué fait de cailloux permet de traverser la rivière. Deux groupes de randonneurs arrivent simultanément sur les berges gauche et droite de cette rivière et veulent la traverser.
Le chemin étant très étroit, une seule personne peut se trouver sur chaque caillou de ce chemin (figure 1).
Un randonneur sur la berge de gauche peut avancer d’un caillou (vers la droite sur la figure 1) et sauter par dessus le randonneur devant lui (un caillou à droite) si le caillou où il atterit est libre.
De même, chaque randonneur de la berge de droite peut avancer d’un caillou (vers la gauche sur la figure 1) et sauter par dessus le randonneur devant lui, dans la mesure où le caillou sur lequel il atterit est libre. Une fois engagés, les randonneurs ne peuvent pas faire marche arrière.
De plus, pour simplifier, on suppose qu’une fois tous les randonneurs sur le chemin, il ne reste qu’un caillou de libre.
Le chemin de cailloux est défini par un tableau d’entiers :
|
1 |
type chemin_caillou = int array |
Dans ce tableau, un randonneur venant de la berge de gauche est représenté par un 1, un randonneur issu de la berge de droite par un 2 et un caillou libre par un 0.
On pourra utiliser ici la fonction copy du module Array.
On supposera dans la suite les fonctions de signature randonneurD_avance : chemin_caillou -> bool et randonneurD_saute : chemin_caillou -> bool écrites de manière similaire pour les randonneurs venant de la berge de droite.
On donne la syntaxe OCaml pour créer une liste de N entiers i : List.init N (fun x->i). Par exemple, List.init 5 (fun x->2);; renvoie [2 ; 2 ; 2 ; 2 ; 2].
Par exemple, passage 3 2 permet de passer de [1 ;1 ;1 ;0 ;2 ;2] à [2 ;2 ;0 ;1 ;1 ;1].
Partie III – Calcul d’une coupe minimum d’un graphe
Un agent secret a pour mission de perturber le réseau de communications ennemi en coupant certains fils dans le réseau. Ayant peu de moyens, l’agent a pour consigne de couper le moins de fils possibles pour accomplir cette tâche.
Le réseau de communications est modélisé à l’aide d’un multigraphe non orienté {G=(S,A)}, où S est l’ensemble des sommets du graphe et A l’ensemble de ses arêtes. Résoudre le problème de l’agent secret, c’est rechercher une coupe minimum dans G.
Définition 4 (Multigraphe)
Un multigraphe est un graphe dans lequel des couples de mêmes sommets peuvent être reliés par plus d’une arête. Dans toute la suite, on considérera les multigraphes sans arêtes du type (s, s) (boucles).
Définition 5 (Coupe)
Une coupe d’un multigraphe non orienté {G=(S,A)} est une partition non triviale ({S_1}, {S_2}) de S , c’est-à-dire telle que {S_1\cup S_2=S}, {S_1\cap S_2=\varnothing} et {S_1,S_2\ne\varnothing}. On dira que les arêtes reliant {S_1} à {S_2} sont les arêtes de la coupe. La taille d’une coupe ({S_1}, {S_2}) est définie par {|(S_1,S_2)|=|\{(s,t)\in A,\ s\in S_1,t\in S_2\}|}.
Autrement dit, c’est le nombre d’arêtes de G qui relient {S_1} et {S_2}.
Définition 6 (Coupe minimum)
Une coupe minimum est une coupe de taille minimale. Pour trouver une coupe minimum d’un multigraphe {G=(S,A)}, on pourrait énumérer l’ensemble des coupes possibles (il y en a {2^{|S|}}…), ou encore utiliser un algorithme de flot (le plus efficace étant en {O(|S|^3)}).
Nous proposons dans la suite un algorithme probabiliste, l’algorithme de Karger, basé sur la notion de contraction d’arête.
III.1 – Contraction d’arête
Soient {G=(S,A)} un multigraphe et {a=(s,t)\in A} une arête de G de sommets s et t. Contracter l’arête a consiste à : (i). créer un nouveau sommet u = (st) dans S . u est un supersommet du nouveau graphe, (ii). pour toute arête (r, s) ou (r, t), {r\in S} , ajouter une arête (r, u) à A.
Dans le cas où (r, s) et (r, t) existent, deux arêtes reliant r à u sont créées. (iii). Supprimer de A toutes les arêtes ayant s ou t comme extrémité. (iv). Supprimer s et t de S .
Un supersommet peut donc être vu comme un ensemble de deux sommets du graphe initial, obtenu après une contraction d’arête. Le multigraphe obtenu est appelé graphe contracté et est noté G/st.
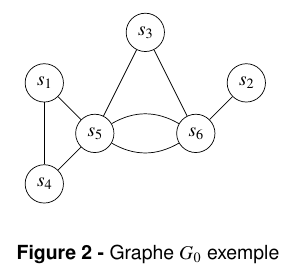
Si plusieurs arêtes relient s à t dans G, contracter l’une d’entre elles supprime toutes les autres du graphe G/st. Dans toute la suite, on notera {G_0} le graphe initial, avant transformations par contractions. On considère le graphe {G_0} de la figure 2.
Après plusieurs contractions, un supersommet u du graphe résultant contient un sous-ensemble {S_u\subseteq S} de sommets de G.
III.2 – Premier algorithme
On construit un premier algorithme qui essaye de trouver une coupe minimum en contractant aléatoirement une arête de G, jusqu’à ce qu’il ne reste que deux sommets (algorithme 3). Algorithme 3 – Algorithme de Karger.
|
1 2 3 4 5 6 7 8 9 |
Karger(G, n) Entrées : G = (S, A) multigraphe non orienté, n ∈ N Sorties : Une coupe minimum de G. début pour i = |S| à n en décrémentant de 1 faire Tirer aléatoirement (loi uniforme) une arête a = (s,t) ∈ A G = G/st // Appel Karger(G,2) |
La coupe calculée est-elle une coupe minimum ?
D’après la Q23, tant que l’on ne contracte pas une arête faisant partie de toutes les coupes minimum de G, alors l’ algorithme 3 trouvera une coupe minimum. On cherche alors la probabilité de ne jamais contracter une telle arête.
Soit C = ({S_1}, {S_2}) une coupe minimum de G. L’objet des questions Q27 et Q28 est de minorer la probabilité que l’ algorithme 3 renvoie C.
Pour cela, on remarque que cet algorithme ne renvoie pas C si et seulement si lors d’une itération on choisit une arête qui traverse C, c’est-à-dire telle qu’un sommet est dans {S_1} et l’autre dans {S_2}.
III.3 – Deuxième algorithme
Le résultat précédent n’est pas satisfaisant d’un point de vue complexité.
On peut cependant l’améliorer facilement en utilisant une technique d’ amplification : on itère l’ algorithme 3 plusieurs fois et on retourne la valeur minimale obtenue (algorithme 4). Algorithme 4 – Algorithme de Karger amplifié.
|
1 2 3 4 5 6 7 8 9 10 11 |
KargerAmplifie(G, N) Entrées : G = (S, A) multigraphe non orienté, N ∈ N. Sorties : Une coupe minimum de G. début t = ∞ pour i = 1 à N faire X = Karger(G,2) si |X| < t alors t = |X| C = X retourner C |
En déduire, pour {c>0} fixé, la plus petite valeur de N telle que cette probabilité soit supérieure à {1-\dfrac1{N^c}} .
Justifier la réponse.
III.4 – Implémentation en langage C
Cette partie comporte des questions de programmation qui seront abordées en utilisant exclusivement le langage C. Les codes seront commentés de manière pertinente.
On suppose qu’un graphe est codé à l’aide de l’ensemble de ses arêtes, chaque arête étant définie par ses deux sommets, représentés par des entiers.
On rappelle la définition d’un type structuré par struct nom_s {type 1 champ 1;…;type n champ n;} et ensuite typedef struct nom_s nom;.
Pour tout u supersommet, les {S_u} forment une partition de S .
Pour coder ces sous-ensembles, on a donc naturellement recours à la structure de données Unir & Trouver (Union-Find), qui va permettre de trouver rapidement à quel sous-ensemble {S_u} un sommet {s\in S} appartient (Trouver) et de fusionner deux supersommets {S_u} et {S_v} déjà construits (Unir).
On suppose donc disposer : (i). d’un type subset, décrivant un supersommet d’un graphe contracté.
|
1 2 3 4 5 6 |
struct subset { int parent; // recherche par compression de chemin pour Trouver int rang; // Union par rang. }; typedef struct subset subset; |
(ii). d’une fonction de prototype int Trouver(subset subsets[], int s), qui retourne le numéro du supersommet dans lequel le sommet s se trouve (par compression de chemin), (iii). d’une fonction de prototype void Unir(subset subsets[], int Su, int Sv) qui fusionne les deux supersommets {S_u} et {S_v} (union par rang) et maintient à jour la liste des supersommets.
Il n’est pas demandé d’écrire ces deux dernières fonctions.
La fonction renvoie 0 si aucune arête est contractée et -1 sinon.
Les supersommets initiaux sont les {|S|} sommets de {G_0}, chacun ayant un rang nul et un numéro parent égal au numéro du sommet. Pour effectuer un tirage aléatoire uniforme, on utilisera la fonction int rand(); de la librairie stdlib.h qui renvoie un nombre aléatoire entre 0 et RAND_MAX {\ge32767}.
RAND_MAX est une constante définie dans stdlib.h.