Concours CPGE EPITA-IPSA-ESME 2023
— Option Sciences du Numérique
— Filière MPI
Consignes générales
Tout code doit être écrit dans les langages Ocaml ou C, suivant l’énoncé.
• Veuillez indenter votre code correctement.
• Tout ce dont vous avez besoin (fonctions, méthodes) est indiqué ci-dessous.
• Vous pouvez écrire vos propres fonctions, dans ce cas elles doivent être documentées (on doit savoir ce qu’elles font). Dans tous les cas, la dernière fonction écrite doit être celle qui répond à la question.
Consignes Ocaml
La partie I demande d’écrire du code en Ocaml.
Toute fonction du module List est utilisable, si nécessaire.
Consignes C
La partie II demande d’écrire du code en langage C. On supposera la bibliothèque standard (stdlib) et la bibliothèque stdbool incluses.
On rappelle que cette dernière bibliothèque définit les deux booléens true et false.
Introduction
Le sujet de l’option Sciences du numérique contient trois sections. Elles sont indépendantes. Le candidat est invité à parcourir intégralement le sujet avant de commencer la rédaction.
I.
Algorithmique sur les arbres et programmation en langage Ocaml : Mots de Dyck et arbres binaires
Définition 1. On appelle mot de Dyck un mot {m} sur l’alphabet {\{a,b\}} tel que :
— {m} contient autant de {a} que de {b} ;
— tout préfixe {m} contient plus de {a} que de {b} ; Par exemple, {m=aababb} est un mot de Dyck, car il possède trois {a} et trois {b}, et ses préfixes sont {\varepsilon} (le mot vide), {a}, {aa}, {aab}, {aaba}, {aabab} et {m}, et aucun ne contient strictement plus de {b} que de {a}.
On représente dans la suite en Ocaml un mot sur l’alphabet {\{a,b\}} par la liste de ses lettres. On définit les types suivants :
|
1 2 |
type lettre = A | B ;; type mot = lettre list ;; |
Le mot {m=aababb} sera donc représenté par la liste [A; A; B; A; B; B].
verifie_dyck de type mot -> bool renvoyant un booléen indiquant si le mot passé en entrée est de Dyck.On admet la propriété suivante : tout mot {m} de Dyck non vide se décompose de manière unique sous la forme {m=aubv}, où {u} et {v} sont des mots de Dyck.
On pourra utiliser sans démonstration la caractérisation suivante : {aub} est le plus petit préfixe non vide de {m} contenant autant de {a} que de {b}.
decompo_dyck de type mot -> mot * mot, prenant en entrée un mot {m} supposé non vide et de Dyck (il est inutile de le vérifier), et renvoyant le couple de mots de Dyck {(u,v)} tel que {m=aubv}.Il existe une bijection naturelle entre les arbres binaires stricts (tout nœud de l’arbre possède 0 ou 2 fils) et les mots de Dyck, basée sur la décomposition précédente :
— au mot vide est associé l’arbre réduit à une feuille ;
— à un mot de Dyck non vide {aubv} où {u} et {v} sont de Dyck, on associe l’arbre binaire où le sous-arbre gauche est associé au mot {u} et le sous-arbre droit au mot {v}.
On définit le type suivant :
|
1 |
type arbre = F | N of arbre * arbre ;; |
mot_a_arbre de type mot -> arbre renvoyant l’arbre binaire strict associé à un mot de Dyck (on ne vérifiera pas que le mot passé en entrée est bien de Dyck).arbre_a_mot de type arbre -> mot faisant l’inverse.II. Algorithmique et programmation en langage C : structure de liste doublement chaînée et applications
II.1. Structure de liste doublement chaînée
On souhaite réaliser une structure de liste doublement chaînée d’entiers, permettant le retrait et l’ajout des deux côtés.
Pour réaliser une telle structure, on utilise, comme sur la figure ci-dessous :
— un type cellule à trois champs : une valeur (entière), et deux pointeurs vers les cellules situées à sa gauche et à sa droite si elles existent, NULL sinon ;
— un type dbliste à deux champs, contenant deux pointeurs vers les cellules situées tout à gauche et tout à droite.
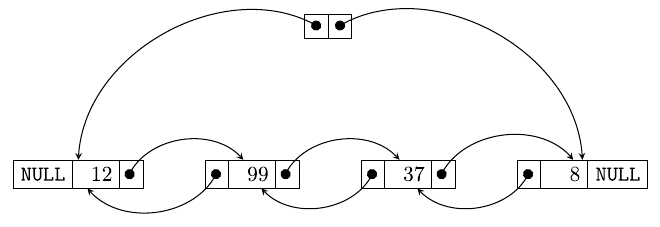
On définit donc les structures suivantes :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
typedef struct cellule cellule; struct cellule { int valeur; cellule* suiv; cellule* prec; }; typedef struct dbliste dbliste; struct dbliste { cellule* gauche; cellule* droite; }; |
On prendra garde au fait que :
— une liste doublement chaînée ne contenant aucun élément sera représentée par un élément de type dbliste pour lequel les deux pointeurs gauche et droite sont NULL ;
— une liste doublement chaînée contenant un seul élément sera représentée par un élément de type dbliste pour lequel les deux pointeurs gauche et droite pointent vers la même cellule.
On définit également la fonction d’initialisation suivante :
|
1 2 3 4 5 |
void init(dbliste* q) { q->gauche = NULL; q->droite = NULL; } |
int elem_g(dbliste* q) permettant de renvoyer l’entier situé à gauche de la liste doublement chaînée pointée par q, en supposant celle-ci non vide.void push_g(dbliste* q, int v) permettant l’ajout de l’entier v à gauche de la liste doublement chaînée pointée par q.
On rappelle que malloc(sizeof(cellule)) permet de réserver un espace mémoire de la taille d’une cellule.
On suppose dans la suite avoir écrit les fonctions d’en-tête suivantes :
— bool vide(dbliste* q) : renvoyant un booléen indiquant si q pointe sur une liste doublement chaînée vide ou non ;
— void push_g(dbliste* q, int v) (resp. void push_d(dbliste* q, int v)) permettant l’ajout de l’entier v à gauche (resp. à droite) de la liste doublement chaînée pointée par q ;
— int elem_g(dbliste* q) (resp. int elem_d(dbliste* q)) renvoyant l’entier situé à gauche (resp. à droite) de la liste doublement chaînée pointée par q, en supposant celle-ci non vide ;
— int take_g(dbliste* q) (resp. int take_d(dbliste* q)) supprimant et renvoyant l’entier situé à gauche (resp. à droite) de la liste doublement chaînée pointée par q, en supposant celle-ci non vide.
La mémoire rendue disponible est libérée.
II.2. Élément majoritaire dans une liste
On s’intéresse dans cette sous-partie au problème suivant : savoir si un tableau contient un élément majoritaire. Si un tableau a une taille {n>0}, un élément de ce tableau est-dit majoritaire s’il apparaît strictement plus que {\lfloor n/2\rfloor} fois (on rappelle que {\lfloor\cdot\rfloor} dénote la partie entière).
Par exemple, un tableau de taille 5 contenant comme éléments 2, 7, 2, 2, 9 possède 2 comme élément majoritaire, alors qu’un tableau contenant 2, 7, 2, 2, 9, 8 n’a pas d’élément majoritaire.
On commence par une résolution naïve du problème.
int occurences(int t[], int taille, int x) prenant en entrée un tableau de taille taille, un élément x, et renvoyant le nombre de fois que x apparaît dans le tableau.bool majoritaire(int t[], int taille) prenant en entrée un tableau de taille taille et renvoyant un booléen indiquant s’il possède un élément majoritaire.On propose une résolution plus efficace dans la suite. Cette approche consiste à calculer d’abord un unique candidat majoritaire, et vérifier si celui-ci l’est effectivement dans un second temps. La première partie de l’approche est détaillée dans l’algorithme ci-dessous.
Pour que celui-ci soit plus visuel, on propose l’analogie suivante : le tableau d’entiers est un seau de balles qui peuvent avoir une certaine couleur (deux éléments identiques du tableau correspondent à deux balles de même couleur).
On dispose d’un tube se comportant comme une pile, et d’une corbeille. Algorithme 1 :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
Entrée : Le seau de balles Sortie : une couleur de balle Créer un tube vide, une corbeille vide; Placer une balle du seau dans le tube; tant que il reste des balles dans le seau faire prendre une balle dans le seau; si la balle est de la même couleur que celle au sommet du tube alors mettre la balle à la corbeille sinon empiler la balle dans le tube; si la corbeille est non vide alors prendre une balle de la corbeille et la mettre dans le tube retourner la couleur de la balle au sommet du tube |
Le but des questions qui suivent est de montrer que si une couleur était majoritaire dans le seau, c’est celle renvoyée par l’algorithme.
Montrer à l’aide de ces invariants qu’elle apparaît moins de {\frac n2} fois dans le seau, avec {n} le nombre initial de balles.
On en déduit donc que pour voir si un tableau admet un élément majoritaire, il suffit d’appliquer l’algorithme précédent, et de tester si l’élément renvoyé est majoritaire. On passe à l’implémentation.
bool majoritaire_eff(int t[], int taille) renvoyant la même chose que la fonction de la question 12, mais en suivant l’approche développée dans cette partie. Vous représenterez le tube comme une pile, et la corbeille par un simple entier (indiquer ce qu’il représente).
Quelle est la complexité de l’approche ?
II.3. Parcours en largeur dans un graphe 0/1
On considère dans cette sous-section des graphes orientés pondérés, où le poids d’un arc ne peut-être que 0 ou 1. Voici un tel exemple de graphe :
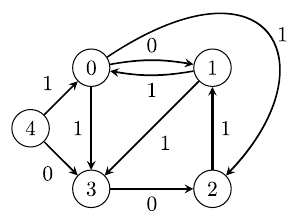
Dans un tel graphe, la distance entre deux sommets {s} et {t} est le plus petit poids d’un chemin (s’il en existe au moins un) reliant {s} à {t}. Par exemple, la distance entre les sommets 0 et 2 est 1. Plusieurs chemins de poids 1 relient 0 à 2, comme {0\to2} ou {0\to1\to3\to2}.
TAILLE qui est le nombre de sommets du graphe (5 dans l’exemple ci-dessus).
Écrire une fonction d’en tête void parcours(int graph[TAILLE][TAILLE], int larg[TAILLE], int s) telle que :
— graph est la matrice d’adjacence du graphe : pour {0\le i,j\le\text{TAILLE}-1}, graph[i][j] contient le poids de l’arc {(i,j)} si celui-ci existe (0 ou 1), {-1} sinon.
On suppose que le graphe est sans boucle donc la diagonale ne contient que des {-1} ;
— larg est un tableau de taille TAILLE, à remplir ;
— s est un sommet du graphe, donc un entier entre 0 et TAILLE - 1 ; cette fonction modifie le tableau larg de sorte qu’à la fin de la fonction larg[i] contient la distance entre {s} et {i} pour tout sommet {i} entre 0 et TAILLE - 1.
Si le sommet {i} n’est pas accessible depuis {s}, on convient de poser larg[i]=-1. Par exemple, avec le graphe représenté ci-dessus, et {s=0}, voici l’état du tableau larg à la fin de l’algorithme : {\begin{array}{c|ccccc}i&0&1&2&3&4\\[8pt]\text{larg}[i]&0&0&1&1&-1\end{array}}Indication : utiliser une liste doublement chaînée pour gérer les sommets à traiter.
Si l’arc {i\to j} est examiné et que {j} est découvert pour la première fois, insérer {j} à gauche de la liste doublement chaînée si graph[i][j]=0, à droite si graph[i][j]=1.
III. Lemme d’Arden et langage reconnu par un automate
Définitions/Notations.
• L’ensemble des langages rationnels sur un alphabet {\Sigma} fixé est la plus petite partie de {\mathcal P(\Sigma^*)} contenant {\varnothing}, {\{\varepsilon\}} et les langages {\{a\}} pour {a\in\Sigma}, et stable par union, concaténation et étoile de Kleene.
On rappelle que pour {L} un langage, {L^*=\bigcup_{n\ge0}L^n}, avec {L^n} l’ensemble des mots s’écrivant comme concaténation de {n} mots de {L}.
• Un automate fini déterministe est un quintuplet {(\Sigma,Q,q_0,F,\delta)} où :
— {\Sigma} est l’alphabet ;
— {Q} est un ensemble fini : l’ensemble des états de l’automate ;
— {q_0\in Q} est l’état initial ;
— {F\subset Q} est l’ensemble des états terminaux ;
— {\delta} est la fonction de transition : c’est une application partielle de {Q\times\Sigma} vers {Q}.
Un couple {(q,a)\in Q\times\Sigma} pour lequel {\delta(q,a)} n’est pas défini est appelé un blocage de l’automate.
• pour {\mathcal A} un tel automate, il est commode d’introduire la fonction de transition étendue {\delta^*}, qui est une application partielle de {Q\times\Sigma^*} vers {Q}, définie par {\forall q\in Q,\ \delta(q,\varepsilon)=q}et, pour tout {(q,a,m)\in Q\times\Sigma\times\Sigma^*}, {\delta^*(q,am)=\left\{\begin{array}{l}\delta^*(\delta(q,a),m)\\[4pt]\quad\text{si ces transitions sont définies}\\[4pt]\text{blocage sinon}.\end{array}\right.}
III.1.
Lemme d’Arden
Dans cette sous-partie, on s’intéresse à l’équation {L=(A\cdot L)\cup B}, où l’inconnue est le langage {L}, {A} et {B} étant deux langages fixés.
On pourra supposer {L} solution de l’équation et montrer par récurrence forte la propriété {P(n)} : « Si {m} est un mot de {L} de longueur {n}, alors {m\in A^*\cdot B} ».
On a donc montré le lemme suivant : Lemme 2 (d’Arden). L’équation {L=(A\cdot L)\cup B} possède {A^*\cdot B} comme solution minimale pour l’inclusion.
Si de plus {\varepsilon\notin A}, c’est la seule solution.
III.2 Un exemple d’application
On considère l’automate suivant, où {q_0} est l’état initial, et {F=\{q_2\}}.
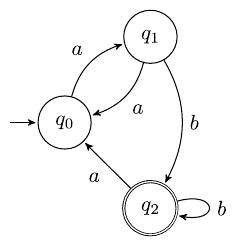
Pour {i\in\{0,1,2\}}, on note {L_i=\{m\in\Sigma^*:\delta^*(q_i,m)\in F\}}.
III.3 Cas général
À l’aide du lemme d’Arden, on souhaite redémontrer le résultat de cours suivant : Théorème 3. Le langage reconnu par un automate fini déterministe est un langage rationnel.
On va en donner une preuve constructive, c’est-à-dire une méthode permettant de calculer une expression rationnelle reconnaissant le langage, à l’aide du lemme d’Arden. Dans la suite, on se donne {\mathcal A=(\Sigma,Q,q_0,F,\delta)} un automate fini déterministe quelconque.
On suppose {Q=\{q_0,\ldots,q_{n-1}\}}, et on note {L_i=\{m\in\Sigma^*:\delta^*(q_i,m)\in F\}}, comme dans la section précédente.
On a donc obtenu un système d’équations en les {(L_i)_{0\le i\le n-1}}. Voyons comment éliminer une inconnue.
On pourra procéder par récurrence, pour cela énoncer clairement la propriété à démontrer.
QCM MPI
Ce QCM est tel que chaque question peut comporter plusieurs bonnes réponses. Cocher une réponse correcte fait gagner des points, mais cocher une réponse fausse annule tous les points de la question.
La majorité des questions suivantes sont formulées au singulier ou au pluriel, par commodité pour la grammaire française, mais sans corrélation directe avec le nombre de réponses correctes.
□ {[\![0,2^n-1]\!]}□ {[\![-2^{n-1},2^{n-1}-1]\!]}
□ {[\![-2^{n-1},2^{n-1}]\!]}
□ {[\![-2^n+1,0]\!]}
□ {[\![-2^n,2^n]\!]}
□ aucune réponse correcte
□ SAT
□ Test de croissance d’un tableau
□ Problème de l’arrêt
□ 3-SAT
□ Test de primalité d’un entier
□ de faire le lien entre les différents composants
□ d’effectuer calculs et opérations logiques
□ de stocker de manière définitive les données des utilisateurs
□ de réaliser des opérations d’entrées-sorties
Dans cette question et la suivante, on considère une table POINTS muni de trois attributs entiers : id, x, y. Cette table réprésente des points du plan à coordonnées entières à qui on a attribué un numéro.
□ FROM POINTS SELECT * ;
□ SELECT COUNT(*) FROM POINTS ;
□ SELECT MAX(id) FROM POINTS ;
□ FROM POINTS SELECT MAX(id) ;
□ SELECT COUNT(x) FROM POINTS ;
□ une requête imbriquée
□ une auto-jointure
□ une agrégation
□ une division
□ le prix Nobel
□ la médaille Fields
□ le prix Tuning
□ le prix Turing
□ le prix Gödel
□ le prix Gogol