Préliminaires
Présentation du sujet
L’épreuve est composée d’un problème unique, comportant 27 questions. Dans ce problème, nous étudions un mécanisme pour lire un mot qui a été brouillé (par exemple corekte) et proposer un mot ciblé comme correction de ce mot (par exemple correct).
Ce type de traitement est couramment utilisé dans le contexte de la vérification orthographique, de la reconnaissance vocale, de la lecture optique ou encore de la conception de moteurs de recherche tolérant aux requêtes mal formulées.
Après cette section de préliminaires, le problème est divisé en trois sections. Dans la première section (page 1), nous étudions comment mesurer des erreurs commises à la saisie d’un mot par une méthode de programmation dynamique.
Dans la deuxième section (page 4), nous étudions comment stocker un corpus de mots par une méthode arborescente et comment fouiller ce corpus à l’aide d’un automate déjà construit.
Dans la troisième section (page 7), nous étudions comment construire un filtre de fouille par une méthode inspirée de la théorie des automates.
Dans tout l’énoncé, un même identificateur écrit dans deux polices de caractère différentes désignera la même entité, mais du point de vue mathématique pour la police en italique (par exemple {n} ou {n\prime}) et du point de vue informatique pour celle en romain avec espacement fixe (par exemple n ou nprime).
Travail attendu
Pour répondre à une question, il sera permis de réutiliser le résultat d’une question antérieure, même sans avoir réussi à établir ce résultat.
Il faudra coder des fonctions à l’aide du langage de programmation OCaml, en reprenant l’en-tête de fonction fourni par le sujet, sans nécessairement recopier la déclaration des types.
Quand l’énoncé demande de coder une fonction, sauf demande explicite de l’énoncé, il n’est pas nécessaire de justifier que celle-ci est correcte ou que des préconditions sont satisfaites.
Le barème tient compte de la clarté des programmes : nous recommandons de choisir des noms de variables intelligibles ou encore de structurer de longs codes par des blocs ou par des fonctions auxiliaires dont on décrit le rôle.
1 Une mesure des erreurs de saisie
1.1 Une fonction mystère
La constante entière max_int désigne le plus grand entier représentable par OCaml. Nous nous donnons la fonction mystere suivante.
|
1 2 3 4 5 |
let rec mystere z = match z with (* La fonction mystere calcule ... *) | [] -> max_int | [a] -> a | a::b::y -> mystere ((if a <=b then a else b)::y);; |
Dans la question suivante, le terme complexité en espace désigne un ordre de grandeur asymptotique de l’espace utilisé en mémoire lors de l’exécution d’un algorithme pour stocker tant l’entrée que des résultats intermédiaires et la valeur de retour.
1.2 Distance d’édition de Levenshtein
Nous fixons un alphabet de 27 symboles {\Sigma=\{a,b,\ldots,y,z,\char36 \}} qui se représentent par le type char. L’ensemble des mots sur l’alphabet {\Sigma} se note {\Sigma^\ast} ; la longueur d’un mot {w\in\Sigma^\ast} se note {|w|}.
Dans toute cette sous-section, nous fixons deux mots : le mot {b=b_1\ldots b_m}, dit brouillé, de longueur {m} et le mot {c=c_1\ldots c_n}, dit ciblé, de longueur {n}.
Définition : Nous appelons distance entre un mot brouillé {b\in \Sigma^\ast} et un mot ciblé {c\in \Sigma^\ast}, et nous notons dist(b, c), le nombre minimum de symboles qu’il faut supprimer, insérer ou substituer à un autre symbole pour transformer le mot brouillé b en le mot ciblé c.
On remarque que dist(b, c) = dist(c, b).
Par exemple, la distance entre le mot brouillé b = corekte et le mot ciblé c = correct vaut 3 : en effet, on peut insérer un r, substituer un c au k et supprimer le e final pour passer du mot b au mot c ; par ailleurs, on peut vérifier que cette transformation est impossible en effectuant deux opérations ou moins.
Nous notons {\operatorname{préf}_i(b)} le préfixe de longueur {i} du mot {b}, c’est-à-dire le mot des {i} premiers symboles de {b}. Pour {i=0}, il s’agit du mot vide {\varepsilon}.
Pour tous les indices {i} compris entre {0} et {m} et pour {j} compris entre {0} et {n}, nous notons {d_{i,j}=\operatorname{dist}(\operatorname{préf}_i(b),\operatorname{préf}_j(c))} la distance entre les préfixes {\operatorname{préf}_i(b)} et {\operatorname{préf}_j(c)}.
Indication Ocaml : Un élément de type char se déclare entre deux apostrophes : par exemple, on code ’a’ pour définir le symbole a. Les mots de {\Sigma^\ast} se représentent par le type char list.
Nous déclarons
|
1 |
type mot = char list;; |
Nous rappelons la syntaxe des fonctions suivantes : — List.length, de type 'a list -> int : la longueur d’une liste ‘ est List.length l ; — Array.make, de type int -> 'a -> 'a array : un tableau de longueur n dont chaque case est initialisée avec la valeur v s’obtient par Array.make n v.
Dans un tableau, les indices sont numérotés à partir de 0. On accède au coefficient en position i du tableau a par l’expression a.(i), on le modifie par l’instruction a.(i) <- v.
Indication Ocaml : Nous rappelons la syntaxe de la fonction suivante : — Array.make_matrix, de type int -> int -> 'a -> 'a array array : une matrice de taille {s\times t} dont toutes les cases sont initialisées avec la valeur v s’obtient par Array.make_matrix s t v. Dans une matrice, les indices sont numérotés à partir de 0.
On accède au coefficient en position (i, j) de la matrice a par l’expression a.(i).(j), on le modifie par l’instruction a.(i).(j) <- v.
Indication Ocaml : Nous rappelons la syntaxe de la fonction suivante : — List.filter, de type ('a -> bool) -> 'a list -> 'a list : la sous-liste des éléments x de la liste ‘ tels que le prédicat p(x) vaut true s’obtient par filter p l.
distance b c en fonction des longueurs {m} et {n} des mots {b} et {c}.
En déduire la complexité de l’instruction List.filter (fun c -> (distance b c) <= k) lc;; où {\ell_c} est une liste de mots ciblés, chacun de longueur inférieure ou égale à {n_{\max}}, et où {k} est un entier naturel.
Montrer qu’il existe un entier {r}, des mots {b_0,b_1,\ldots,b_r} appartenant chacun à {\Sigma^\ast}, des mots {c_0,c_1,\ldots,c_r} appartenant chacun à {\Sigma^\ast} et des symboles {x_0,x_1,\ldots,x_{r-1}} appartenant chacun à {\Sigma} tels que {\begin{array}{c}b=b_0x_0b_1\ldots x_{r-1}b_r\\[8pt]\text{et }c=c_0x_0c_1\ldots x_{r-1}c_r\\[8pt]\displaystyle\text{et }k=\sum_{i=0}^r\max(|b_i|,|c_i|)\end{array}}
2 Fouille dans un trie
2.1 Représentation d’un corpus de mots par un trie
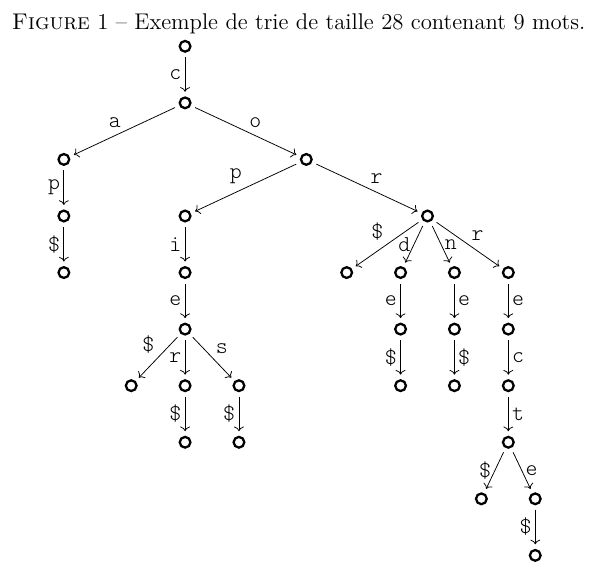
Définition : Un trie est un type particulier d’arbre dont chaque arête est orientée de la racine vers les feuilles et est étiquetée par un symbole de {\Sigma}. Le trie vide est formé d’un seul sommet et de zéro arête.
Lorsqu’une arête est étiquetée par le symbole $, son extrémité finale doit être le trie vide. La taille d’un trie t, notée |t|, est le nombre de ses arêtes.
On dit qu’un mot {c=c_1\ldots c_n\in(\Sigma\setminus\{\char36 \})^n} appartient à un trie s’il existe un chemin, constitué de {n+1} arêtes, issu de la racine et dont les arêtes successives ont pour étiquettes respectives les symboles {c_1,c_2,\ldots,c_n} et $. Le symbole $ indique la présence d’un mot et joue le rôle de symbole terminateur.
Dans cette partie, les tries sont utilisés afin de représenter un corpus de mots ciblés.
Dans ce sujet, le terme dictionnaire désigne en général un type de données abstrait qui contient des associations entre une clé et une valeur.
Pour chacune d’entre elles, rappeler sans justifier la complexité en temps de l’opération insertion.
Indication Ocaml : Nous définissons un type polymorphe ’a char_map qui réalise une structure de données persistante de dictionnaire associant des clés de type char à des valeurs de type quelconque ’a.
Nous disposons de la constante et de la fonction suivante : — CharMap.empty, de type ’a char_map, qui désigne le dictionnaire vide. — CharMap.add, de type char -> 'a -> 'a char_map -> 'a char_map, telle que la valeur de retour de CharMap.add x t d est un dictionnaire contenant les associations du dictionnaire d ainsi qu’une association supplémentaire entre la clé x et la valeur t.
Si la clé x était déjà associée dans le dictionnaire d, l’ancienne association de x disparaît. Pour représenter les tries, nous définissons le type
|
1 |
type trie = Node of trie char_map ;; |
Indication Ocaml : Nous utilisons un type polymorphe ’a option défini par
|
1 2 3 |
type 'a option = | None | Some of 'a;; |
qui permet de représenter des valeurs de type ’a parfois non définies.
Nous complétons le type ’a char_map par la fonction suivante : — CharMap.find, de type char -> 'a char_map -> 'a option, telle que l’appel de CharMap.find x d renvoie, en temps constant, Some t si la clé x est associée à la valeur t dans le dictionnaire d et renvoie None s’il n’existe pas d’association de clé x dans le dictionnaire d.
Compte tenu du caractère persistant du type ’a char_map, combien d’exemplaires de trie_vide coexiste-t-il une fois la construction terminée ? Expliquer.
Définition : Un trie est dit élagué si toute feuille est précédée d’une arête d’étiquette $.
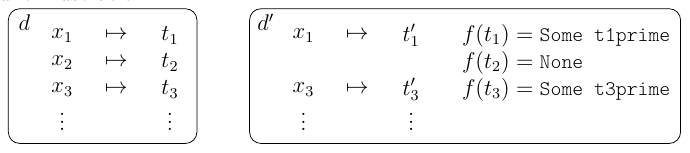
Indication Ocaml : Nous complétons le type ’a char_map par les fonctions suivantes : — CharMap.is_empty, de type 'a char_map -> bool, qui teste si un dictionnaire est le dictionnaire vide. — CharMap.filter_map, de type (char -> 'a -> 'a option) -> 'a char_map -> ’a char_map, telle que CharMap.filter_map f d renvoie le dictionnaire {d\prime} restreint aux associations entre la clé x et la valeur {t\prime} où, d’une part, il existe dans le dictionnaire d une association entre la clé x et la valeur t et, d’autre part, f (t) vaut Some tprime.
Si le dictionnaire d contient un couple clé et valeur (x, t) mais que f (t) vaut None, alors le dictionnaire {d\prime} ne contient pas d’association de clé x. En voici une illustration :
|
1 2 3 4 5 |
let rec trie_trim (Node tcm:trie) : trie = let filtre (x:char) (y:trie) : trie option = (* a completer *) in Node(CharMap.filter_map filtre tcm);; |
2.2 Filtrage dans un trie
En déduire la complexité en temps de l’instruction List.filter (fun bb -> trie_mem bb t) lb;;.
Définition : Nous appelons système de transitions sur l’alphabet {\Sigma} la donnée d’un triplet {(Q,\hat q,\Delta)} où — Q est un ensemble (fini ou non), dit ensemble des états, — {\hat q\in Q} est un état, dit état initial, — {\Delta\subseteq Q\times\Sigma\times Q} est une relation, dite relation de transition.
Un mot {c=c_1\ldots c_n\in\Sigma^n} est accepté par le système de transitions {(Q,\hat q,\Delta)} s’il existe une suite d’états {(q_j)_{0\le j\le n}} telle que l’état {q_0} égale l’état initial {\hat q} et, pour tout {j} compris entre {0} et {n-1}, le triplet {(q_j,c_{j+1},q_{j+1})} appartient à la relation de transition {\Delta}.
On peut voir un système de transitions comme un automate éventuellement infini dont tous les états sont finals.
Nous disons qu’un système de transitions {(Q,\hat q,\Delta)} est déterministe s’il existe une fonction partiellement définie {\delta:Q\times\Sigma\to Q} telle que l’on ait {\begin{array}{l}\Delta=\{(q,x,\delta(q,x))\\[4pt]\qquad\qquad\mid(q,x)\in Q\times\Sigma\text{ et }\delta(q,x)\text{ est défini}\}\end{array}}Nous notons alors {(Q,\hat q,\delta)} ce système.
Indication Ocaml : Afin de représenter des systèmes de transitions déterministes, nous convenons de nous appuyer sur un type etat pour représenter l’ensemble des états Q. Ce type sera explicité ultérieurement. Nous déclarons
|
1 |
type syst_trans = etat -> char -> etat option;; |
pour représenter la fonction de transition {\delta}.
Pour tout couple {(q,x)\in Q\times\Sigma}, si delta est de type syst_trans, on accède à l’état image {q'=\delta(q,x)} par l’expression delta q x qui vaut alors Some qprime si la transition est bien définie ou bien None si la transition n’est pas définie.
Il n’est pas demandé de renvoyer un trie élagué.
On suppose que l’exécution de la fonction de transition {\delta} s’effectue en temps constant.
3 Système de transitions des voisins d’un mot brouillé
Dans toutes les questions restantes, les lettres b et c désignent systématiquement deux mots de longueur m et n de {(\Sigma\setminus\{\char36 \})^\ast}. La lettre k désigne un entier naturel. L’écriture c$ désigne la concaténation du mot c et du symbole $ ; nous parlons alors de mot prolongé.
L’objectif de cette section est de construire un système de transitions non déterministe qui, à partir d’un entier naturel k et d’un mot brouillé b, accepte n’importe quel préfixe du mot prolongé {c\prime=c\char36} où c est un mot de {(\Sigma\setminus\{\char36 \})^\ast} tel que {\operatorname{dist}(b,c)\le k} et aucun autre mot n’est accepté.
Définition : Nous appelons transformations élémentaires les (k + 3) appellations suppr, subs et h-ins-puis-id, avec {0\le h\le k} ; nous notons T leur ensemble. Soient {c'=c'_1\ldots c'_n\in\Sigma^\ast} un mot de longueur {n} et {b'\in\Sigma^\ast} un mot de longueur {m}.
Nous disons qu’une suite {\tau=(\tau_1,\tau_2,\ldots,\tau_n)} de {n} transformations élémentaires est un script de transformation du mot {c'} en le mot {b'} s’il existe une factorisation {\beta_1\beta_2\ldots\beta_n} du mot {b'} telle que pour tout entier {j} compris entre {1} et {n},
(1) {\beta_j} est un mot de {\Sigma^\ast},
(2) lorsque {\tau_j=\mathrm{suppr}}, alors le mot {\beta_j} est le mot vide {\varepsilon},
(3) lorsque {\tau_j=\mathrm{subs}}, alors le mot {\beta_j} est de longueur {1} et, en l’identifiant à un symbole, il est distinct du symbole {c'_j},
(4) lorsque {\tau_j=h\text{-}\mathrm{ins}\text{-}\mathrm{puis}\text{-}\mathrm{id}}, alors le mot {\beta_j} est de longueur {h+1} et le dernier symbole de {\beta_j} vaut le symbole {c'_j}. Nous observons que la factorisation du mot {b'} en {\beta_1\beta_2\ldots\beta_n} est unique et ne dépend que du script {\tau} .
Voici un exemple de script de transformation entre le mot {c\prime} = correct$ et le mot {b\prime} = incorekte$.
| Symbole | Bloc produit | Transformation |
|---|---|---|
| c | inc | 2-ins-puis-id |
| o | o | 0-ins-puis-id |
| r | r | 0-ins-puis-id |
| r | {\varepsilon} | suppr |
| e | e | 0-ins-puis-id |
| c | k | subs |
| t | t | 0-ins-puis-id |
| $ | e$ | 1-ins-puis-id |
Définition : Le coût d’une transformation élémentaire est précisé par le tableau suivant :
| Transformation élémentaire | Coût |
|---|---|
| suppr | 1 |
| subs | 1 |
| h-ins-puis-id | h |
Le coût d’un script de transformation est la somme des coûts des transformations élémentaires constituant le script.
Dans l’exemple ci-dessus, le coût du script vaut 5 (ou encore 2 + 0 + 0 + 1 + 0 + 1 + 0 + 1). Définition : Nous utilisons le terme k-script pour raccourcir l’expression « script de transformation de coût inférieur ou égal à k ».
Dans les questions 24 et 25, la lettre {j} désigne un entier avec {0\le j\le n} et {\tau=(\tau_1,\tau_2,\ldots,\tau_j)\in\mathcal T^j} un {k}-script depuis le préfixe {\operatorname{préf}_j(c\char36 )} du mot prolongé {c\char36} vers un certain préfixe {p} du mot prolongé {b\char36}. On appelle {s} le suffixe de {b\char36} tel que {b\char36} se factorise en {b\char36 =ps}.
On exprimera sa réponse en fonction du {(j+1)^e} symbole {c_{j+1}} de {c\char36}, du suffixe {s} et du coût {\kappa} du script {\tau}.
Indication Ocaml : Nous précisons le type etat en déclarant
|
1 |
type etat = mot * int;; |
On définira une fonction etat_initial (b:mot) (k:int) : etat qui construit l’état initial {\hat q} et une fonction delta (k:int) (q:etat) (x:char) : etat list qui renvoie la liste des états {q\prime} tels que l’on ait {(q,x,q')\in\Delta}.
Pourquoi peut-on souhaiter adapter la fonction trie_filter plutôt que de déterminiser le système de transitions ?