Partie I – Automates
L’objectif de cette partie est de proposer quelques éléments autour d’un automate, dit augmenté, construit autour d’un automate fini non déterministe et d’un sous-ensemble d’états.
Définition 1 (Automate fini non déterministe)
Un automate fini non déterministe est un quintuplet {\mathcal A=(Q,\Sigma,I,\delta,F)} avec :
– Q un ensemble fini non vide d’états, de cardinal {|Q|} ;
– {\Sigma} un alphabet ;
– {I\subset Q} l’ensemble des états initiaux ;
– {\delta:Q\times\Sigma\to\mathcal P(Q)} une fonction de transition : si {q\in Q} et {a\in\Sigma}, {\delta(q,a)} désigne l’ensemble des états {q'} de Q tels qu’il existe une transition étiquetée par a de q vers {q'} ;
– {F\subset Q} l’ensemble des états finaux.
Définition 2 (Automate augmenté)
Soient {\mathcal A=(Q,\Sigma,I,\delta,F)} un automate fini non déterministe et {O\subset Q} un sous-ensemble d’états de Q. On appelle automate augmenté par O la paire {(\mathcal A,O)}, que l’on notera par la suite {\mathcal A_O}.
La notion de calcul est la même entre A et {\mathcal A_O} : un calcul dans A est une séquence d’états {q_1\cdots q_n} de Q telle qu’il existe toujours au moins une transition entre deux états successifs de cette séquence.
Le mot construit par concaténation des étiquettes de chacune des transitions est alors reconnu par l’automate. L’ensembleO introduit la notion de calcul réussi au seuil s.
Définition 3 (Calcul réussi au seuil s)
Soit {\mathcal A_O} un automate augmenté. Un calcul passant par les états {q_i\in Q,\ i\in\llbracket0,n\rrbracket} est dit réussi au seuil {s\in\mathbb N} si : i) {q_0\in I} ; ii) {q_n\in F} ; iii) pour tout {i\ge0} tel que {i+s\le n}, {\{q_i,\ldots,q_{i+s}\}\cap O\ne\varnothing}.
Définition 4 (Langage reconnu par un automate augmenté au seuil s)
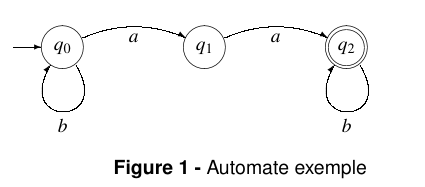
Soit {\mathcal A_O} un automate augmenté et {s\in\mathbb N}. Le langage reconnu par {\mathcal A_O} au seuil s, noté {L_s(\mathcal A_O)}, est l’ensemble des calculs réussis par {\mathcal A_O} au seuil s. On considère, pour les questions 1 à 3, l’automate de la figure 1, où {Q=\{q_0,q_1,q_2\}}, {\Sigma=\{a,b\}}, {I=\{q_0\}} et {F=\{q_2\}}.
i) une majoration de {i_0} ; ii) un encadrement de {i_k} ; iii) une majoration de {i_{j+1}-i_j} pour {j\in\llbracket0,k-1\rrbracket}.
Pour {s\in\mathbb N}, construire, en justifiant votre construction, un automate fini à {(s+1)p} états reconnaissant {L_s(\mathcal A_O)}.
Partie II – Autour des tas
Cette partie comporte des questions de programmation qui seront abordées en utilisant exclusivement le langage Python (Informatique Pour Tous). L’objectif est ici d’étudier et d’implémenter quelques outils autour d’une structure de données appelée tas binomial .
Un tas binomial est une structure assez proche du tas binaire (utilisé par exemple pour réaliser une file de priorité), pour lequel la procédure de fusion de deux tas est efficace et peu complexe.
II.1 – Arbre binomial
Définition 5 (Arbre enraciné)
Un arbre enraciné est un graphe acyclique orienté possédant une unique racine et tel que tous les nœuds sauf la racine ont un unique parent.
La figure 2 présente un exemple d’arbre enraciné dans lequel r est la racine.
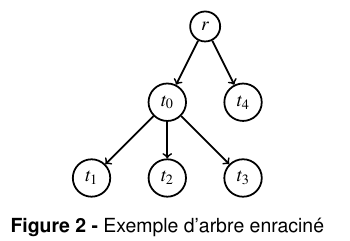
On définit un arbre enraciné (non vide) par un couple {(r,[t_0,\ldots,t_{n-1}])}, où r est la valeur de la racine et {[t_0,\ldots,t_{n-1}]} est la liste de ses fils, chaque {t_i,\ i\in\llbracket0,n-1\rrbracket} étant un arbre. Un arbre vide est défini par None.
Par abus de notation, on confond dans la suite la racine de l’arbre et sa valeur, ainsi que les fils d’un arbre avec leur racine.
– Vide(a) qui renvoit True si l’arbre a est vide, False sinon ;
– Racine(a) qui renvoit la racine de a si a est non vide ;
– Fils(a) qui renvoit la liste des arbres, fils de la racine de a.
Définition 6 (Arbre binomial)
Un arbre binomial {a_k} d’ordre {k\ge0} est un arbre enraciné dans lequel les fils de chaque nœud sont ordonnés. Il est défini récursivement comme suit : i) {a_0=(r,[])} est constitué d’un nœud unique, la racine ; ii) pour {k\in\mathbb N}, soit {a_k=(r,[t_0,\ldots,t_{n-1}])} un arbre non vide. {a_k} est un arbre binomial d’ordre k si :
– {t_{n-1}} est un arbre binomial d’ordre ({k-1}) ;
– {(r,[t_0,\ldots,t_{n-2}])} est un arbre binomial d’ordre ({k-1}) ;
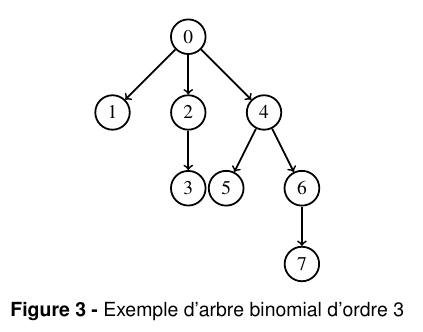
– la racine de {t_{n-1}} a une valeur supérieure ou égale à r. La figure 3 donne un exemple d’arbre binomial d’ordre 3. Les valeurs dans l’arbre sont des entiers.
Dans la suite, on note {a_1\oplus a_2} cette opération.
II.2 – Tas binomial
Un tas est une structure de données de type arbre qui permet en particulier de retrouver directement un élément qui doit être traité en priorité.
Définition 7 (Tas binomial)
Soient {k\ge0} et {T=\{a_0,\ldots,a_k\}} un ensemble d’arbres. T est un tas binomial de longueur k + 1 si, pour tout {i\in\llbracket0,k\rrbracket}, {a_i} est soit un arbre vide, soit un arbre binomial d’ordre i. Si i = k, {a_i} ne peut, de plus, pas être vide et {a_k} est donc un arbre binomial d’ordre k.
On note dans la suite {|T|} le nombre de nœuds d’un tas T.
Définition 8 (Signature d’un tas)
Soit {T=\{a_0,\ldots,a_k\}} un tas binomial de longueur k + 1. On appelle signature de T la suite {s_0\cdots s_k} telle que pour tout {i\in\llbracket0,k\rrbracket}, {s_i=0} (respectivement {s_i=1}) si l’arbre {a_i} est vide (respectivement n’est pas vide).
En donner la complexité en fonction de {|T|}.
Les tas se construisent itérativement à partir de données. On est donc amené, pour un tas T, à ajouter un à un des éléments. Soit p un élément que l’on souhaite ajouter à un tas binomial T non vide et déjà construit.
L’insertion de la valeur p dans le tas T se fait alors selon l’algorithme 1. Algorithme 1 – Insertion de p dans T.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
Entrées : un tas T={a0 … ak}, une valeur p Sorties : un tas T augmenté de la valeur p début i ← 0 Coder p dans un arbre binomial a d’ordre 0 tant que i < k + 1 et a non vide faire si ai est vide alors ai ← a Vider a sinon a ← a ⊕ ai (***) Vider ai i ← i + 1 si a n’est pas vide alors Ajouter a au tas T. |
Partie III – Autour de l’énumération des fractions positives
Cette partie comporte des questions nécessitant un code OCaml. Pour ces questions, les réponses ne feront pas appel aux fonctionnalités impératives du langage (en particulier pas de boucles, pas de références).
Notations
Dans la suite, on notera :
– {n\wedge d} le PGCD (Plus Grand Commun Diviseur) de n et d ;
– {\lceil x\rceil} la partie entière supérieure de x. Ainsi {\lceil3.45\rceil=4} ;
– {\lfloor x\rfloor} la partie entière inférieure de x. Ainsi {\lfloor3.45\rfloor=3} ;
– {\log_2} la fonction logarithme de base 2. C’est la fonction réciproque de la fonction {i\mapsto2^i}. Une fraction, ou nombre rationnel, est le quotient de deux nombres entiers, le dénominateur étant par définition non nul. On notera {\mathbb Q^+} l’ensemble des fractions positives.
L’objectif de cette partie est d’étudier une structure de données permettant d’énumérer l’ensemble des fractions positives. Plusieurs travaux se sont intéressés à l’énumération des nombres rationnels, le plus connu étant très certainement la méthode de Cantor.
Cependant, il n’est très souvent pas possible, à moins d’un travail assez complexe, de connaître une formule générale donnant le i-ième terme de cette énumération, ni même de donner le successeur dans l’énumération d’une fraction donnée.
Nous proposons dans la suite de répondre à ces questions en construisant un arbre, dit de Calkin-Wilf, permettant de manipuler cette énumération.
Définition 9 (Arbre binaire infini)
Un arbre binaire homogène est un arbre binaire dont tous les nœuds ont 0 successeur ou 2 successeurs, appelés fils gauche et droit. La hauteur h de l’arbre est la profondeur maximale des nœuds de l’arbre, c’est-à-dire la plus grande longueur d’un chemin de la racine vers une feuille de l’arbre.
Lorsque h est infinie, on parle d’ arbre infini.
Définition 10 (Arbre de Calkin-Wilf)
L’arbre de Calkin-Wilf est un arbre binaire homogène infini dont les nœuds sont des fractions positives. La racine de l’arbre est la fraction 1/1. Chaque sommet n/d a deux descendants : un fils gauche {n/(n+d)} et un fils droit {(n+d)/d}.
Ainsi, si N = n/d, les deux fils de N sont {\dfrac{N}{1+N}} (gauche) et 1 + N (droit).
On propose le type record :
|
1 |
type fraction = {n:int; d:int} |
pour définir une fraction de type n/d. La déclaration d’une telle fraction sera donc du type :
|
1 |
let f = {n=2;d=3};; |
l’accès au numérateur (respectivement dénominateur) s’opérant par f.n;; (resp. f.d;; ).
Au besoin, elle simplifie la fraction par {n\wedge d}.
Par la suite, on ne construira des valeurs de type fraction que par l’intermédiaire de la fonction fraction, ce qui permettra de garantir l’invariant de type suivant : « pour toute valeur f : fraction, f.n et f.d sont premiers entre eux ».
On définit alors une suite {(v_i)_{i\in\mathbb N}}, avec {v_0=0}, puis en effectuant un parcours en largeur, de gauche à droite, de l’arbre de Calkin-Wilf pour définir les termes de la suite.
La suite {(v_i)_{i\in\mathbb N}} permet donc d’affirmer que {\mathbb Q^+} est dénombrable. Nous allons utiliser {(v_i)_{i\in\mathbb N}} pour déterminer, dans l’énumération des fractions produite par cette suite, la position de n’importe quelle fraction positive n/d.
En d’autres termes, étant donnée une fraction positive n/d, on se propose de rechercher i tel que n/d = {v_i}.
Pour pouvoir énoncer le i-ième terme dans cette énumération, on introduit alors une suite auxiliaire, aux nombreuses propriétés arithmétiques et liens avec d’autres objets mathématiques.
La suite diatomique de Stern (ou suite de Stern-Brocot ) doit son nom à Moritz Stern (1807-1894), élève de Gauss et Achille Brocot (1817-1878), horloger qui s’intéressait aux fractions pour la fabrication d’horloges avec des engrenages comportant peu de dents, donc simples à fabriquer.
Définition 11 (Suite diatomique de Stern ou suite de Stern-Brocot)
La suite diatomique de Stern {(s_i)_{i\in\mathbb N}} est définie par {s_0=0}, {s_1=1} et pour tout {i\ge1} : {\left\{\begin{array}{l}s_{2i}=s_i\\[8pt]s_{2i+1}=s_i+s_{i+1}\end{array}\right.}
La suite diatomique de Stern permet d’exprimer le i-ième terme dans l’énumération des fractions positives qui est induite par le parcours en largeur de l’arbre de Calkin-Wilf décrit ci-dessus.
Voyons maintenant comment obtenir de manière rapide le successeur d’une fraction {v_i} donnée, sans connaître i, dans cette énumération. Trois cas peuvent se présenter :
– premier cas : les nœuds de valeur {v_i} et {v_{i+1}} sont à même profondeur k, fils d’un même nœud N,
– deuxième cas : le nœud de valeur {v_i} est le dernier nœud à droite à la profondeur k,
– troisième cas : les nœuds de valeur {v_i} et {v_{i+1}} sont à même profondeur k, mais ne sont pas fils d’un même nœud. On pose pour tout {x>0}, {f(x)=\dfrac{1}{1+2\lfloor x\rfloor-x}}.
On étudie enfin le dernier cas : les nœuds de valeur {v_i} et {v_{i+1}} sont sur une même profondeur k, mais ne sont pas les fils d’un même nœud. On va donc passer par la recherche d’un ancêtre commun de ces deux nœuds.
Dans la suite, on s’intéressera toujours au premier ancêtre commun, c’est-à-dire celui de profondeur maximale. En partant de la racine r, il est possible d’atteindre n’importe quel nœud N = n/d de l’arbre par une suite de déplacements vers la gauche (G) ou vers la droite (D).
Le chemin de r vers N peut donc être codé par un mot sur l’alphabet {G,D}.
Si un déplacement est représenté en OCaml par un type
|
1 |
type direction = G | D |
alors un chemin est une liste direction list.
Ainsi chemin n d calcule la liste des directions à prendre pour passer de r au nœud n/d.
On pourra supposer l’existence d’une fonction de signature rev : direction list -> direction list qui renverse une liste.
Cette fonction fera appel à une fonction auxiliaire récursive.
Cette fonction pourra utiliser une fonction auxiliaire récursive.
Donner de même le chemin entre {v_p} et {v_{i+1}}.